

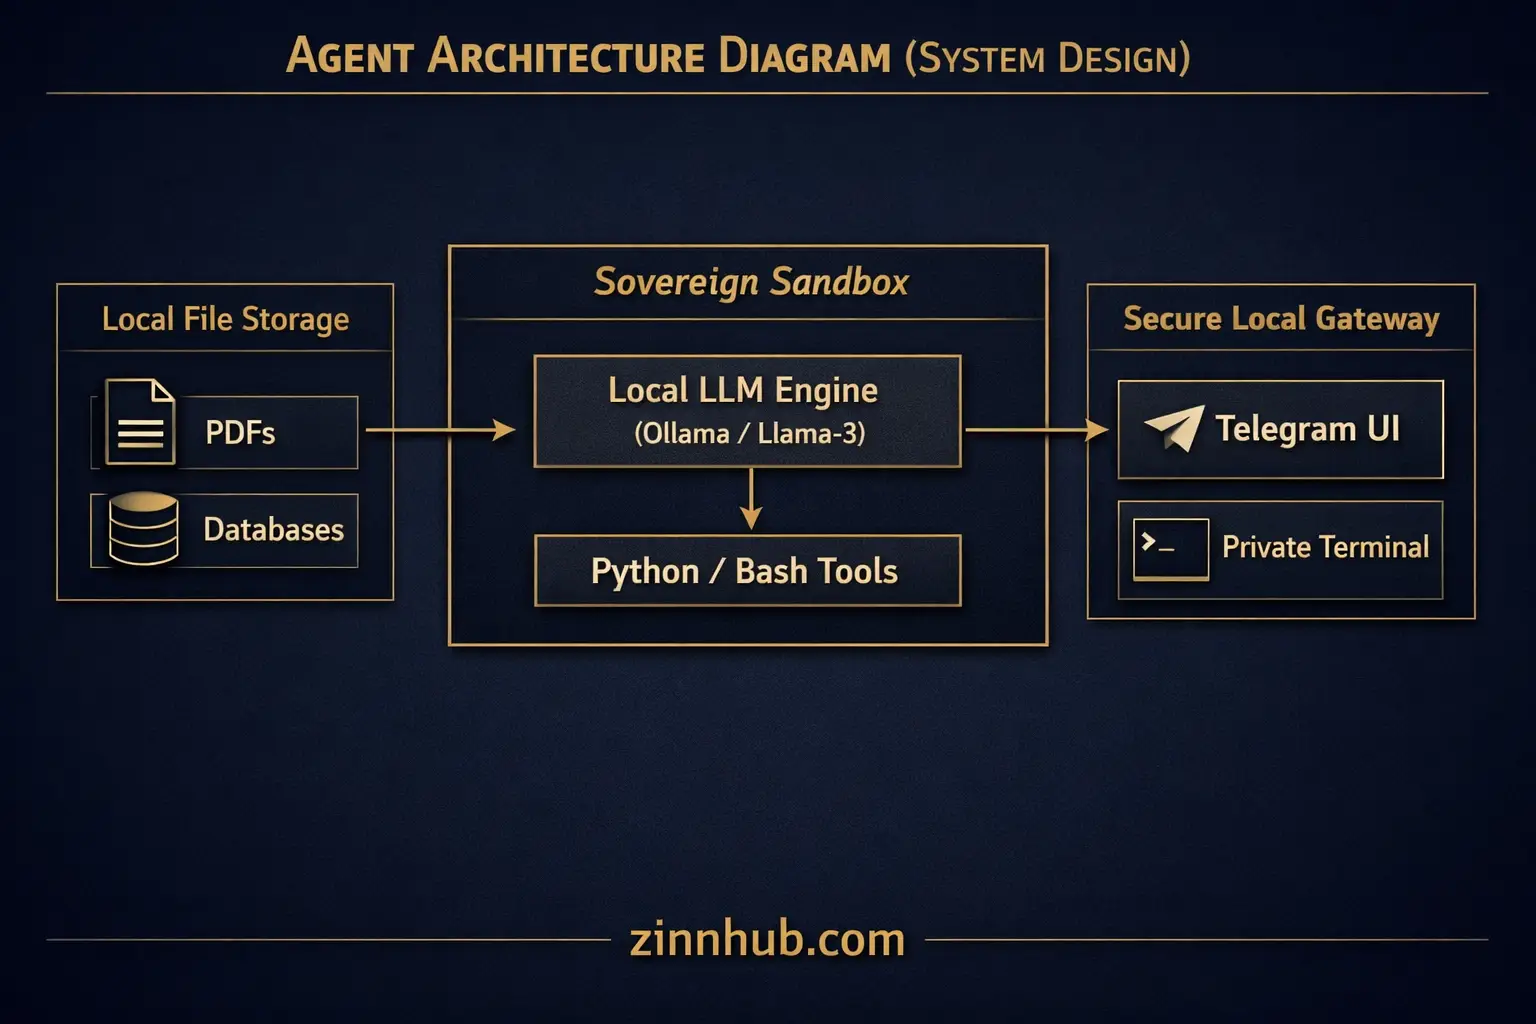
L'exécution de LLM locaux et de pipelines RAG nécessite un équilibre précis des ressources matérielles. Si les paramètres de votre modèle dépassent la VRAM GPU ou la RAM système disponible, la vitesse d'exécution chute à près de zéro car votre système d'exploitation est contraint d'utiliser le stockage système. Ceci…
Je vais effectuer un audit de compatibilité matérielle et modèle local
Demander une offre personnalisée
Se connecter pour demander une offre personnalisée
Créez un compte gratuit ou connectez-vous pour demander une offre personnalisée à ce Zinner.
Connexion / InscriptionPoser une question avant achat
Se connecter pour poser une question
Pour réduire le spam sur la plateforme, les messages avant vente ne peuvent être envoyés que par les utilisateurs connectés.
Créez un compte gratuit ou connectez-vous pour envoyer un message directement à ce Zinner.
Connexion / InscriptionConnexion requise
Créez un compte gratuit ou connectez-vous pour envoyer un message à ce Zinner.
Connexion / InscriptionConnexion requise
Créez un compte gratuit ou connectez-vous pour demander une offre personnalisée.
Connexion / InscriptionAperçu
Détails clés sur ce service pour vous aider à décider. Généré par Zinn Hub, pas par le vendeur.
Valeur Position
Ce que vous recevez
Délai rapide
Ce que vous devez fournir
Meilleur pour
Description complète
L'exécution de modèles LLM locaux et de pipelines RAG nécessite un équilibre précis des ressources matérielles. Si les paramètres de votre modèle dépassent votre VRAM GPU ou RAM système disponible, la vitesse d'exécution chute à zéro car votre système d'exploitation est forcé d'utiliser le stockage système.
Ce Micro Zinn fournit un audit de compatibilité complet de votre matériel avant d'acheter ou d'installer un logiciel. Nous évaluons votre système physique — qu'il s'agisse d'un Mac Apple Silicon, d'une station de travail NVIDIA CUDA ou d'un serveur Windows/Linux standard — pour vous dire exactement comment atteindre des performances locales optimales.
Ce que nous analysons:
1. Contraintes de VRAM GPU: Nous cartographions votre mémoire graphique dédiée pour trouver votre plafond maximal de paramètres de modèle (par exemple, modèles 7B, 13B ou 34B).
2. Allocation de RAM système: Nous déterminons vos seuils d'inférence CPU et vos limites de déchargement si vous ne disposez pas de GPU dédié ou si vous utilisez une mémoire système partagée.
3. Cartographie de la quantification: Nous recommandons le niveau de quantification exact (tel que Q4_K_M, Q5_K_M ou Q8_0) pour équilibrer la vitesse de traitement et l'intelligence du modèle.
4. Limites de la fenêtre contextuelle: Nous calculons vos limites maximales de jetons sécurisées pour éviter les plantages du système par manque de mémoire lors de la récupération intensive de documents.
Arrêtez de deviner quels poids open-source télécharger ou pourquoi votre configuration locale est lente. Obtenez une carte technique spécifique au matériel pour votre environnement d'IA local auprès d'opérateurs qui construisent ces systèmes sur du matériel physique quotidiennement.
Audit de compatibilité matérielle complété mappant les limites des paramètres du modèle Ollama, les échelles de fenêtre de contexte et les quantifications Q4/Q5 optimales pour 128 Go de RAM.
Voir l'exemple ↗Un Micro Zinn est un petit service d'essai ou micro-service à prix fixe. CAVOK_Designs propose celui-ci pour:
Vitrine de compétencesCréateur de portfolioOuvert à de nouveaux clientsGarantie de Qualité Zinner
Chaque Zinner est examiné et approuvé avant de rejoindre la plateforme.
Tous les services sont soutenus par notre engagement en matière d'assurance qualité.
Votre paiement est protégé jusqu'à ce que vous approuviez le travail livré.
Avis clients
Découvrez ce que nos clients disent de ce Zinn

