Fatigué de payer des frais d'API mensuels? Je déploierai un modèle d'IA local privé et hors ligne 100% (Ollama, Qwen, Llama) sur votre matériel. Aucune fuite de données, utilisation illimitée. Livraison rapide par un expert full-stack. Consultez mon portfolio: www.dsecho.cn

Je déploierai un LLM d'IA local privé et créerai une automatisation Python sur votre matériel
Installez un LLM local privé (Qwen/Llama) sur votre PC à l'aide d'Ollama. 100% hors ligne et sécurisé.
- Configuration LLM locale
- Documentation incluse
- 100% Hors ligne et privé
Tout ce qui est inclus dans l'offre de base, PLUS une interface utilisateur Web propre (Open WebUI) et des scripts d'automatisation Python personnalisés.
- Tout dans Basic
- Interface utilisateur Web incluse
- Scripts Python personnalisés
- Support prioritaire
Tout ce qui est inclus dans l'offre Standard, PLUS une optimisation matérielle avancée, une automatisation Python complexe et un support technique individuel.
- Tout inclus dans le forfait Standard
- Optimisation matérielle
- Automatisation avancée
- Support individuel
Demander une offre personnalisée
Se connecter pour demander une offre personnalisée
Créez un compte gratuit ou connectez-vous pour demander une offre personnalisée à ce Zinner.
Connexion / InscriptionPoser une question avant achat
Se connecter pour poser une question
Pour réduire le spam sur la plateforme, les messages avant vente ne peuvent être envoyés que par les utilisateurs connectés.
Créez un compte gratuit ou connectez-vous pour envoyer un message directement à ce Zinner.
Connexion / InscriptionConnexion requise
Créez un compte gratuit ou connectez-vous pour envoyer un message à ce Zinner.
Connexion / InscriptionConnexion requise
Créez un compte gratuit ou connectez-vous pour demander une offre personnalisée.
Connexion / InscriptionAperçu
Détails clés sur ce service pour vous aider à décider. Généré par Zinn Hub, pas par le vendeur.
Valeur Position
Méthode de déploiement
Modèles pris en charge
Niveau de confidentialité
Livraison & Support
Ce que vous recevrez
Description complète
Êtes-vous fatigué de payer des frais d'abonnement mensuels coûteux à OpenAI ou Anthropic?
Êtes-vous préoccupé par l'envoi de vos données commerciales sensibles vers le cloud?
Bonjour, je suis Deep Stace Echo, le fondateur de DSEcho Studio (www.dsecho.cn). Je suis un développeur full-stack passionné spécialisé dans la création de systèmes d'IA 100% privés, hors ligne et auto-hébergés.
Lorsque vous travaillez avec moi, vous obtenez un système qui fonctionne entièrement sur votre propre matériel. Pas d'internet requis, pas de fuites de données et zéro facture d'API mensuelle.
Ce que vous obtiendrez:
1. Déploiement d'IA locale et de LLM
Je déploierai et optimiserai des modèles open source de pointe (comme Qwen ou Llama) directement sur votre PC, Mac ou serveur à l'aide d'Ollama. Que vous ayez un GPU haut de gamme ou simplement un CPU, je configurerai le bon modèle et le format quantifié pour qu'il fonctionne en douceur.
2. Cadres d'agents IA personnalisés
Je n'installe pas seulement des chatbots de base. Je construis des agents IA intelligents avec des capacités avancées:
-
Système de mémoire bionique: Permet à l'IA de se souvenir de longues conversations et de contourner les limites traditionnelles de la fenêtre contextuelle.
-
Génération d'outils autonomes: L'IA peut écrire et exécuter ses propres scripts Python pour résoudre automatiquement des tâches complexes.
3. Automatisation et scriptage Python
Besoin de récupérer des données Web, de traiter des fichiers Excel ou d'automatiser un flux de travail répétitif? J'écris des scripts Python propres et très efficaces avec une documentation détaillée afin que vous puissiez facilement les maintenir.
Mon processus:
-
Discussion: Vous me contactez avec les spécifications de votre matériel et vos objectifs.
-
Déploiement: Je configure l'environnement, télécharge les modèles et configure les paramètres à distance ou fournis un script en un clic.
-
Test et livraison: Nous testons le système ensemble. Je fournis un README (documentation) étape par étape afin que vous sachiez exactement comment utiliser et mettre à jour votre IA.
Pourquoi me choisir?
-
Communication directe: Vous parlez directement au développeur qui écrit le code. Pas d'intermédiaires, pas d'agences.
-
Code propre et documenté: Je livre une vraie valeur, pas une boîte noire.
-
Livraison rapide: La plupart des tâches de déploiement sont effectuées en 24 à 48 heures.
Ne dépendez plus du cloud. Construisons votre propre infrastructure d'IA privée dès aujourd'hui!
Envoyez-moi un message avant de commander afin que nous puissions discuter de vos besoins exacts et assurer une adéquation parfaite.
Garantie de Qualité Zinner
Chaque Zinner est examiné et approuvé avant de rejoindre la plateforme.
Tous les services sont soutenus par notre engagement en matière d'assurance qualité.
Votre paiement est protégé jusqu'à ce que vous approuviez le travail livré.
Comparer les forfaits
| Fonctionnalités | Basique | Agent IA standard et automatisation | IA personnalisée premium et Full Stack |
|---|---|---|---|
| Délai de livraison | 2 jours | 3 jours | 5 jours |
| Révisions | 1 | 2 | 3 |
| Configuration LLM locale | ✓ | ✕ | ✕ |
| Documentation incluse | ✓ | ✕ | ✕ |
| 100%Hors ligne et privé | ✓ | ✕ | ✕ |
| Tout en Basic | ✕ | ✓ | ✕ |
| Interface utilisateur Web incluse | ✕ | ✓ | ✕ |
| Scripts Python personnalisés | ✕ | ✓ | ✕ |
| Support prioritaire | ✕ | ✓ | ✕ |
| Tout en Standard | ✕ | ✕ | ✓ |
| Optimisation matérielle | ✕ | ✕ | ✓ |
| Automatisation avancée | ✕ | ✕ | ✓ |
| Support individuel | ✕ | ✕ | ✓ |
Portfolio
Exemples du travail du vendeur relatifs à ce Zinn.
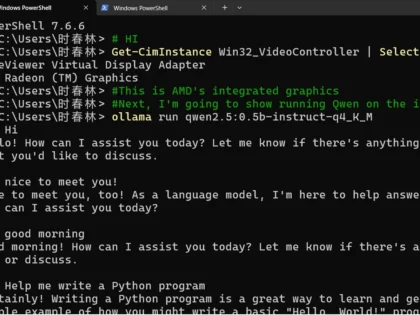
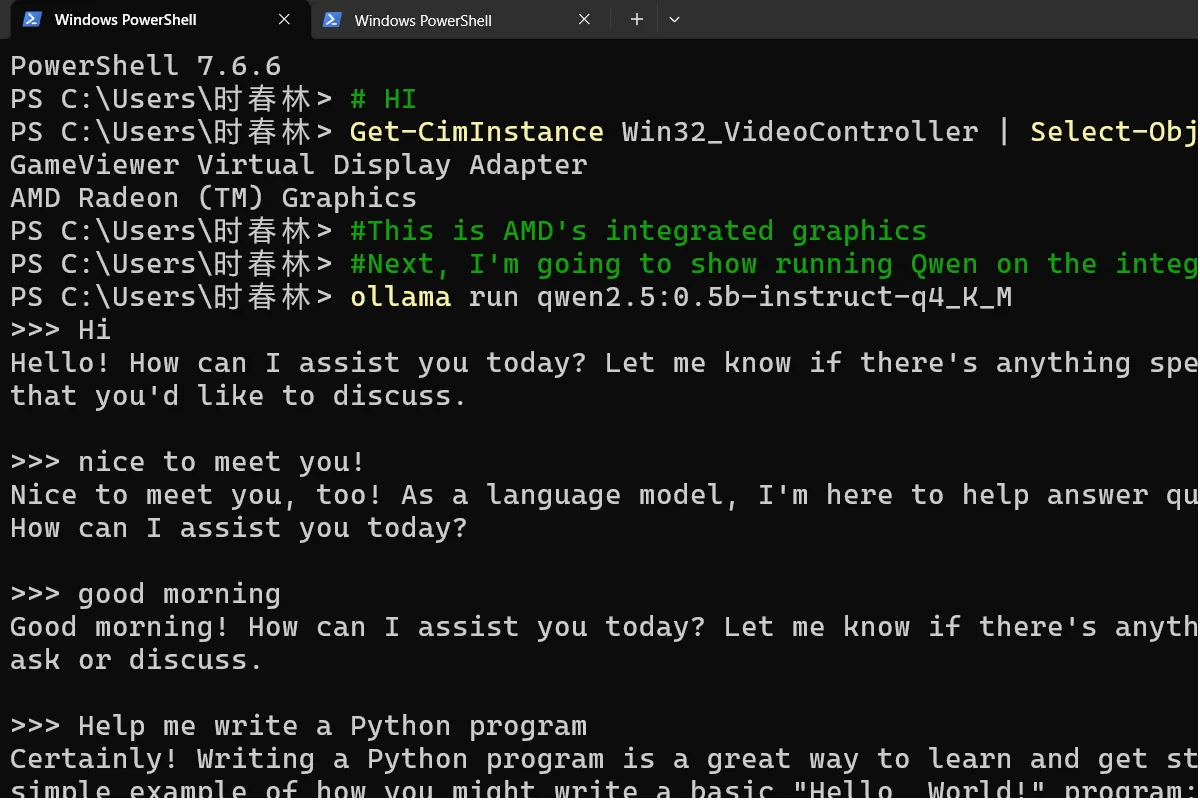
Exécuter des modèles d'IA sur des cartes graphiques intégrées AMD (iGPU)
Vous voulez exécuter des LLM locaux mais vous n'avez pas de GPU NVIDIA? Je peux déployer et optimiser des modèles d'IA (comme Qwen/Llama) directement sur votre carte graphique intégrée AMD en utilisant des technologies comme Vulkan ou ROCm. 100% hors ligne et privé.
Détails du service
Questions fréquemment posées
Veuillez m'envoyer un message avant de commander! J'analyserai votre CPU/GPU et votre RAM pour déterminer quel modèle quantifié (comme une version 4 bits ou 8 bits) fonctionne sans problème sur votre machine. Si votre matériel ne peut exécuter aucun LLM local, vous obtiendrez un remboursement complet.
Absolument. Une fois la configuration terminée et le modèle téléchargé, vous pouvez débrancher votre câble Internet et l'IA fonctionnera toujours parfaitement. Vos données ne quittent jamais votre machine, ce qui est parfait pour les documents commerciaux sensibles.
Avis clients
Découvrez ce que nos clients disent de ce Zinn
Catégories
Politiques Zinner
Zinns connexes

Je vais intégrer des agents IA et des LLMs personnalisés dans vos flux de travail métier

Je vais créer des intégrations API IA personnalisées et des agents en Python

Je construirai des solutions NLP et LLM en Python pour vos données