Upah Pakar Pangkalan Pengetahuan & RAG
Pengetahuan organisasi anda terkunci dalam dokumen, wiki, pangkalan data dan sistem fail yang tidak dapat diakses oleh model AI secara lalai — dan satu-satunya cara untuk membina sistem AI yang menjawab soalan dengan tepat daripada data khusus anda adalah penjanaan tambahan pengambilan. RAG ialah seni bina yang mengubah model AI tujuan umum menjadi pakar dalam perniagaan anda dengan menyambungkannya ke dokumen anda pada masa pertanyaan, memberikannya konteks yang diperlukan untuk memberikan jawapan yang berasas, tepat, boleh dipetik dan bukannya respons generik atau maklumat yang dihalusinasi.
Di Zinn Hub, jurutera AI berpengalaman membina saluran paip RAG tersuai, sistem pangkalan data vektor, aliran kerja pengambilan dokumen, chatbot pangkalan pengetahuan, pelaksanaan carian hibrid dan rangka kerja penilaian yang menjadikan pengetahuan organisasi anda boleh dicari melalui bahasa semula jadi. Ini adalah pakar yang memahami timbunan RAG penuh — penghuraian dokumen, strategi pemecahan, model pembenaman, pangkalan data vektor, algoritma pengambilan, kejuruteraan segera untuk penjanaan berasaskan, dan metodologi penilaian yang memisahkan sistem yang boleh dipercayai daripada yang tidak boleh dipercayai. Bayar dengan kripto pada setiap penyenaraian dan $500 pertama anda adalah bebas komisen.
Mengapa RAG Penting untuk Perniagaan Anda
Setiap organisasi mempunyai masalah pengetahuan — maklumat kritikal tersebar di seluruh dokumentasi, polisi, artikel bantuan, wiki dalaman, benang Slack, arkib e-mel dan kepakaran individu. Pekerja menghabiskan berjam-jam mencari jawapan yang wujud di suatu tempat dalam organisasi tetapi sukar dicari. Pelanggan menunggu respons sokongan sementara ejen mencari melalui pangkalan pengetahuan secara manual. Ahli pasukan baharu mengambil masa berbulan-bulan untuk menyesuaikan diri kerana pengetahuan institusi tidak didokumenkan atau terkubur. RAG menyelesaikan masalah ini dengan mencipta lapisan AI di atas pengetahuan sedia ada anda yang boleh ditanya oleh sesiapa sahaja dalam bahasa semula jadi. Daripada mencari melalui berpuluh-puluh dokumen dan berharap kata kunci yang betul sepadan, pengguna bertanya soalan secara semula jadi dan menerima jawapan yang tepat dengan petikan yang menunjuk kepada dokumen sumber. AI tidak meneka — ia mengambil petikan yang relevan daripada data anda dan menjana jawapan berdasarkan bukti tersebut. Ini secara asasnya berbeza daripada memberi pekerja akses kepada ChatGPT, yang tidak tahu apa-apa tentang perniagaan khusus anda. Sistem RAG yang dilatih pada dokumentasi anda menjadi pakar yang sentiasa tersedia mengenai produk, proses, polisi dan prosedur anda — yang menjawab secara konsisten, tidak pernah lupa, dan berskala untuk melayani setiap orang dalam organisasi anda secara serentak.
Perkhidmatan RAG & Pangkalan Pengetahuan di Zinn Hub
- Pembangunan Saluran Paip RAG Tersuai — Sistem penjanaan tambahan pengambilan hujung ke hujung yang menghubungkan dokumen anda ke model AI. Pengambilan dokumen, pemecahan, pembenaman, penyimpanan vektor, pengambilan, kejuruteraan gesaan dan penjanaan jawapan dengan sokongan petikan.
- Persediaan & Konfigurasi Pangkalan Data Vektor — Pemasangan Pinecone, Weaviate, Qdrant, Milvus, ChromaDB atau pgvector, reka bentuk skema, strategi pengindeksan, penapisan metadata, konfigurasi ruang nama dan pengoptimuman prestasi pertanyaan.
- Saluran Pengambilan Dokumen — Pemprosesan automatik PDF, dokumen Word, hamparan, halaman web, Confluence, Notion, SharePoint, Google Drive dan sumber lain ke dalam kandungan yang dipecah, dibenamkan, diindeks dengan pengesanan perubahan dan pengindeksan semula secara berperingkat.
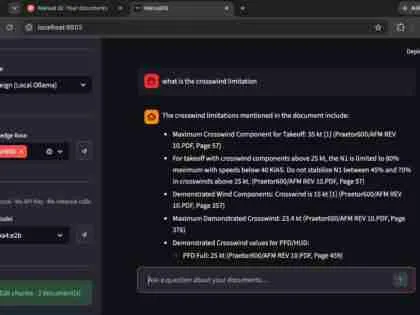
- Sistem Soal Jawab Dokumen Berkuasa AI — Antara muka sembang atau carian di mana pengguna bertanya soalan bahasa semula jadi dan menerima jawapan yang tepat yang bersumberkan daripada dokumentasi anda dengan petikan, skor keyakinan dan pautan ke bahan sumber.
- Chatbot Pangkalan Pengetahuan — Pembantu AI yang berhadapan dengan pelanggan atau dalaman yang menjawab soalan daripada pangkalan pengetahuan anda, dokumen produk, pusat bantuan, SOP atau dokumen polisi dengan antara muka berjenama, sejarah perbualan dan pengumpulan maklum balas.
- Pelaksanaan Carian Hibrid — Menggabungkan carian kesamaan vektor dengan carian kata kunci BM25 untuk mendapatkan semula yang mengendalikan kedua-dua makna semantik dan terminologi tepat, jargon teknikal dan nama khas yang mungkin terlepas oleh carian vektor tulen.
- Pengoptimuman Strategi Chunking — Ujian sistematik pendekatan chunking bersaiz tetap, semantik, rekursif dan induk-anak terhadap jenis kandungan anda dengan perbandingan ketepatan yang dikuantifikasi untuk menentukan strategi optimum.
- Pemilihan & Penalaan Halus Model Pembenaman — Penandaarasan OpenAI, Cohere, Voyage, BGE, E5 dan model pembenaman lain terhadap data anda. Penalaan halus pilihan pada perbendaharaan kata domain anda untuk relevansi pengambilan yang lebih baik.
- Sistem RAG Berbilang Modal — Pengambilan semula imej, rajah, carta dan jadual selain teks, membolehkan AI menjawab soalan tentang kandungan visual yang terbenam dalam dokumen anda.
- Penilaian & Pemantauan RAG — Saluran paip penilaian automatik yang mengukur ketepatan pengambilan, ketepatan jawapan, kadar halusinasi dan kualiti respons. Papan pemuka pemantauan pengeluaran dengan penjejakan ketepatan, metrik kependaman dan analitik penggunaan.
Lapisan Seni Bina RAG
Sistem RAG pengeluaran melibatkan pelbagai lapisan teknikal yang masing-masing mempengaruhi kualiti jawapan. Lapisan pengambilan mengendalikan penghuraian, pembersihan dan pemecahan dokumen. Lapisan pembenaman menukar cebisan teks kepada perwakilan vektor. Lapisan penyimpanan — pangkalan data vektor — mengindeks dan menyajikan vektor ini untuk carian kesamaan yang pantas. Lapisan pengambilan menggabungkan strategi carian, menggunakan penapis dan menyusun hasil. Lapisan penjanaan menggunakan kejuruteraan gesaan untuk mengasaskan respons model AI dalam konteks yang diambil. Dan lapisan penilaian mengukur kualiti hujung ke hujung. Kelemahan pada mana-mana lapisan merendahkan keseluruhan sistem, itulah sebabnya RAG memerlukan pakar yang memahami timbunan penuh, bukan hanya satu komponen.
Perkhidmatan Berkaitan
Pembangunan RAG dan pangkalan pengetahuan bersambung dengan perkhidmatan AI dan pembangunan lain di Zinn Hub. Untuk prompt yang menggerakkan lapisan penjanaan sistem RAG anda, semak imbas perkhidmatan kejuruteraan prompt. Untuk aliran kerja automatik yang mencetuskan pertanyaan RAG dan memproses hasilnya, lihat perkhidmatan automasi dan aliran kerja AI. Untuk membina antara muka berkuasa RAG tanpa kod, terokai pembangunan tanpa kod dan kod rendah. Untuk latihan model AI tersuai dan penalaan halus yang melengkapkan RAG, semak imbas kategori induk pembangunan AI. Untuk infrastruktur pelayan yang mengehos pangkalan data vektor terurus sendiri dan saluran paip RAG, lihat pentadbiran pelayan Linux. Untuk saluran paip penggunaan dan infrastruktur sebagai kod untuk sistem RAG, semak imbas perkhidmatan kejuruteraan DevOps.
Adakah anda seorang jurutera RAG yang berpengalaman? Mula menjual perkhidmatan RAG dan pangkalan pengetahuan di Zinn Hub dan berhubung dengan perniagaan di seluruh dunia yang memerlukan sistem penjanaan tambahan pengambilan tersuai, kepakaran pangkalan data vektor dan carian dokumen berkuasa AI. Daftar sebagai Zinner secara percuma dan mula menyenaraikan hari ini.
Cara Mengupah Pakar RAG & Pangkalan Pengetahuan
Tentukan Sumber Data dan Kes Penggunaan Anda Kenal pasti dokumen dan data yang perlu dicari oleh sistem AI anda — PDF, artikel bantuan, wiki, pangkalan data, halaman web atau dokumentasi dalaman. Tentukan cara pengguna akan berinteraksi dengan sistem dan nyatakan keperluan ketepatan serta jenis soalan yang dijangkakan.
Pilih Pakar RAG Semak imbas perkhidmatan RAG dan pangkalan pengetahuan di Zinn Hub. Semak portfolio untuk pengalaman dengan jenis dokumen, volum data dan persekitaran penggunaan anda. Semak ulasan pembeli untuk ketepatan jawapan dan kebolehpercayaan sistem. Hantar mesej kepada pakar untuk membincangkan keperluan anda.
Sediakan Dokumen dan Akses Kongsi koleksi dokumen anda atau berikan akses API kepada platform kandungan anda. Berikan contoh soalan, jawapan yang dijangka untuk penilaian, dan sebarang terminologi khusus domain. Nyatakan keperluan kawalan akses jika pengguna yang berbeza harus melihat kandungan yang berbeza.
Nilai, Laksanakan dan Pantau Semak hasil penilaian yang menunjukkan ketepatan pengambilan, ketepatan jawapan dan kadar halusinasi. Uji dengan pengguna sebenar dan kes-kes pinggir. Laksanakan dengan papan pemuka pemantauan yang menjejaki ketepatan, penggunaan dan prestasi. Terima dokumentasi seni bina penuh dan prosedur penyelenggaraan.
Soalan Lazim Mengenai RAG & Pangkalan Pengetahuan
Apakah perkhidmatan RAG dan pangkalan pengetahuan yang boleh saya beli di Zinn Hub?+
Zinn Hub menawarkan rangkaian penuh perkhidmatan pembangunan RAG dan pangkalan pengetahuan daripada jurutera AI yang berpengalaman. Anda boleh membeli pembangunan saluran paip RAG tersuai — sistem penjanaan tambahan perolehan hujung ke hujung yang menghubungkan dokumen, pangkalan data dan sumber pengetahuan anda kepada model AI supaya ia menjawab soalan dengan tepat menggunakan data khusus anda. Persediaan dan konfigurasi pangkalan data vektor — pemasangan Pinecone, Weaviate, Qdrant, Milvus, ChromaDB atau pgvector, reka bentuk skema, strategi pengindeksan, penapisan metadata dan pengoptimuman pertanyaan. Saluran paip pengambilan dokumen — memproses PDF, dokumen Word, hamparan, halaman web, wiki Confluence, pangkalan data Notion, pustaka SharePoint dan sumber lain ke dalam kandungan yang dipecah, dibenamkan, diindeks sedia untuk perolehan. Sistem Soal Jawab dokumen berkuasa AI — antara muka chatbot atau carian di mana pengguna bertanya soalan bahasa semula jadi dan menerima jawapan yang tepat yang diperoleh terus daripada dokumentasi anda dengan petikan. Chatbot pangkalan pengetahuan — pembantu AI yang berhadapan dengan pelanggan atau dalaman yang menjawab soalan daripada pangkalan pengetahuan anda, dokumentasi produk, artikel pusat bantuan, SOP atau dokumen dasar. Pelaksanaan carian hibrid — menggabungkan carian kesamaan vektor dengan carian kata kunci tradisional menggunakan BM25 untuk perolehan yang mengendalikan kedua-dua makna semantik dan terminologi tepat. Pengoptimuman strategi pemecahan — menguji dan melaksanakan pendekatan pembahagian dokumen yang betul untuk jenis kandungan anda, mengimbangi saiz pecahan, pertindihan dan pemeliharaan metadata untuk ketepatan perolehan yang optimum. Pemilihan dan penalaan halus model pembenaman — memilih model pembenaman yang betul untuk domain dan jenis kandungan anda, menanda aras alternatif, dan secara pilihan menala halus pembenaman pada data anda untuk meningkatkan korelasi perolehan. Sistem RAG berbilang modal — perolehan ke atas imej, rajah, jadual dan carta sebagai tambahan kepada teks, membolehkan AI menjawab soalan tentang kandungan visual dalam dokumen anda. Dan penilaian dan pemantauan RAG — membina saluran paip penilaian yang mengukur ketepatan perolehan, ketepatan jawapan, kadar halusinasi dan kualiti respons dengan pemarkahan automatik.
Berapakah kos perkhidmatan RAG dan pangkalan pengetahuan di Zinn Hub?+
Kos bergantung pada kerumitan seni bina RAG, volum dan kepelbagaian dokumen sumber, serta tahap ketepatan yang diperlukan. Sistem RAG asas yang menyerap koleksi dokumen tunggal sehingga 500 halaman dengan antara muka sembang ringkas berharga $500-1500. Saluran paip RAG pengeluaran dengan pelbagai sumber dokumen, carian hibrid, penapisan metadata, penjanaan petikan dan UI sembang yang digilap berharga $1500-5000. Persediaan dan konfigurasi pangkalan data vektor dengan reka bentuk skema, pengoptimuman pengindeksan dan penalaan pertanyaan berharga $300-1000. Saluran paip penyerapan dokumen yang memproses kandungan daripada Confluence, Notion, SharePoint atau platform lain dengan penyegerakan automatik berharga $500-2000. Chatbot pangkalan pengetahuan yang berhadapan dengan pelanggan dengan antara muka berjenama, sejarah perbualan, pengumpulan maklum balas dan analitik berharga $1000-4000. Pelaksanaan carian hibrid yang menggabungkan carian vektor dan kata kunci dengan penalaan perkaitan berharga $500-1500. Pengoptimuman strategi pemecahan dengan ujian sistematik merentasi pelbagai pendekatan dan perbandingan ketepatan kuantitatif berharga $300-1000. Penanda aras dan pemilihan model pembenaman untuk domain kandungan khusus anda berharga $300-800. Sistem RAG perusahaan yang komprehensif dengan pelbagai sumber data, kawalan akses berasaskan peranan, pengelogan audit, saluran paip penilaian dan pemantauan berterusan berharga $3000-10000. Penyelenggaraan bulanan berterusan termasuk pengindeksan semula, pemantauan ketepatan, kemas kini segera dan penyegerakan sumber biasanya berkisar antara $200-800 sebulan.
Apakah itu RAG dan bagaimana ia berfungsi?+
RAG — Retrieval Augmented Generation — ialah seni bina yang menghubungkan model bahasa AI kepada data khusus anda supaya ia boleh menjawab soalan dengan tepat menggunakan maklumat daripada dokumen, pangkalan data dan sumber pengetahuan anda dan bukannya bergantung semata-mata pada data latihannya. Tanpa RAG, model AI hanya boleh bertindak balas berdasarkan apa yang mereka pelajari semasa latihan — mereka tidak boleh mengakses dokumentasi dalaman anda, spesifikasi produk, dasar syarikat, data pelanggan atau sebarang maklumat yang tidak ada dalam set latihan mereka. RAG menyelesaikan masalah ini dengan menambah langkah pengambilan sebelum penjanaan. Proses ini berfungsi dalam tiga peringkat. Pertama, dokumen anda diproses semasa fasa pengambilan — ia dibahagikan kepada cebisan, setiap cebisan ditukar menjadi perwakilan berangka yang dipanggil embedding menggunakan model embedding, dan embedding ini disimpan dalam pangkalan data vektor bersama teks asal dan metadata. Kedua, apabila pengguna bertanya soalan, soalan itu juga ditukar menjadi embedding dan pangkalan data vektor dicari untuk cebisan yang embeddingnya paling serupa dengan embedding soalan — ini adalah carian semantik, mencari kandungan mengikut makna dan bukannya padanan kata kunci. Ketiga, cebisan yang paling relevan diambil dan dihantar kepada model AI sebagai konteks bersama soalan pengguna, dan model menjana jawapan berdasarkan kandungan yang diambil itu. Hasilnya ialah sistem AI yang menjawab soalan dengan tepat menggunakan data khusus anda, boleh memetik sumbernya, kekal terkini apabila dokumen anda dikemas kini, dan tidak mengkhayalkan maklumat kerana ia menjana daripada bukti yang diambil dan bukannya ingatan.
Apakah pangkalan data vektor dan mengapa saya memerlukannya untuk RAG?+
Pangkalan data vektor ialah pangkalan data khusus yang direka untuk menyimpan dan mencari vektor numerik berdimensi tinggi — representasi matematik teks, imej atau kandungan lain yang dicipta oleh model pembenaman. Pangkalan data tradisional mencari mengikut padanan tepat atau corak kata kunci. Pangkalan data vektor mencari mengikut kesamaan — diberikan vektor pertanyaan, ia mencari vektor tersimpan yang paling hampir dalam makna, walaupun ia menggunakan perkataan yang sama sekali berbeza. Anda memerlukan pangkalan data vektor untuk RAG kerana carian semantik adalah mekanisme teras yang menjadikan pengambilan berfungsi. Apabila pengguna bertanya soalan tentang dokumentasi anda, sistem perlu mencari petikan yang paling relevan — bukan dengan memadankan kata kunci, tetapi dengan memahami makna. Soalan tentang dasar pemulangan perlu mencari dokumentasi pemulangan anda walaupun perkataan "pemulangan" yang tepat tidak muncul dalam pertanyaan. Pangkalan data vektor menjadikan carian kesamaan ini pantas dan berskala, walaupun merentasi berjuta-juta cebisan dokumen. Pangkalan data vektor popular termasuk Pinecone yang merupakan perkhidmatan awan terurus sepenuhnya dengan akses API mudah dan penskalaan automatik. Weaviate yang merupakan sumber terbuka dengan carian hibrid terbina dalam yang menggabungkan pengambilan vektor dan kata kunci. Qdrant yang merupakan sumber terbuka dengan keupayaan penapisan yang kuat dan penggunaan memori yang cekap. ChromaDB yang ringan dan mesra pembangun, sesuai untuk prototaip dan penggunaan yang lebih kecil. Milvus yang merupakan sumber terbuka dan direka untuk penggunaan perusahaan berskala besar. Dan pgvector yang merupakan sambungan PostgreSQL yang menambah carian vektor ke pangkalan data PostgreSQL sedia ada anda, mengelakkan keperluan untuk sistem yang berasingan. Pilihan bergantung pada skala, pilihan infrastruktur, sama ada anda mahukan terurus atau dihoskan sendiri, dan sama ada anda memerlukan ciri seperti carian hibrid, berbilang penyewa atau penapisan lanjutan.
Apakah perbezaan antara RAG dan penalaan halus model AI?+
RAG dan penalaan halus menyelesaikan masalah yang berbeza dan sering dikelirukan. Penalaan halus mengubah suai model AI itu sendiri dengan melatihnya pada data tambahan — model secara kekal mempelajari corak baharu, gaya penulisan atau pengetahuan domain. RAG tidak mengubah suai model — ia menyediakan konteks yang relevan pada masa pertanyaan daripada pangkalan pengetahuan luaran, dan model menjana jawapan berdasarkan konteks tersebut. Penalaan halus adalah yang terbaik untuk mengajar model gaya penulisan, nada atau format tertentu. Untuk membenamkan terminologi khusus domain dan corak penaakulan ke dalam model. Untuk mengurangkan panjang gesaan dengan mengekod arahan biasa ke dalam berat model. Dan untuk tugas di mana pengetahuan yang diperlukan adalah stabil dan tidak berubah dengan kerap. RAG adalah yang terbaik untuk menjawab soalan daripada koleksi dokumen yang besar dan berkembang. Untuk tugas di mana maklumat sumber berubah dengan kerap dan perlu sentiasa terkini. Untuk menyediakan jawapan yang dipetik, boleh disahkan yang boleh dikesan kepada dokumen sumber tertentu. Untuk bekerja dengan data proprietari atau sensitif yang tidak boleh dimasukkan dalam latihan model. Dan untuk tugas di mana ketepatan dan keaslian lebih penting daripada penyesuaian gaya. Dalam praktiknya, RAG adalah pilihan yang tepat untuk kebanyakan pangkalan pengetahuan perniagaan dan aplikasi Soal Jawab dokumen kerana maklumat berubah dari semasa ke semasa, pengguna perlu mengesahkan jawapan terhadap sumber, dan jumlah kandungan terlalu besar untuk disesuaikan ke dalam model secara ekonomi. Kedua-dua pendekatan boleh digabungkan — model yang disesuaikan yang juga menggunakan RAG untuk pengambilan — tetapi kebanyakan pelaksanaan bermula dengan RAG sahaja kerana ia memberikan nilai segera tanpa kos dan kerumitan latihan model.
Bagaimana saya mengendalikan pelbagai jenis dokumen dalam sistem RAG?+
Pangkalan pengetahuan dunia nyata mengandungi pelbagai jenis dokumen yang masing-masing memerlukan pendekatan pengambilan yang berbeza. PDF adalah yang paling biasa dan paling mencabar — ia boleh mengandungi teks, jadual, imej, pengepala, pengaki, susun atur berbilang lajur dan halaman yang diimbas. PDF berasaskan teks dihuraikan dengan pustaka seperti PyMuPDF, pdfplumber atau Unstructured, dengan pengendalian khas diperlukan untuk jadual dan susun atur berbilang lajur. PDF yang diimbas memerlukan OCR dengan alat seperti Tesseract atau perkhidmatan OCR awan sebelum teks boleh dipecah dan dibenamkan. Dokumen Word dihuraikan dengan python-docx atau pustaka serupa, mengekalkan struktur pengepala untuk pemecahan pintar yang menghormati hierarki dokumen. Hamparan memerlukan penukaran baris atau bahagian kepada penerangan bahasa semula jadi atau perwakilan teks berstruktur yang boleh diproses oleh model pembenaman secara bermakna. Halaman web dikikis dan dibersihkan untuk mengekstrak kandungan utama sambil membuang navigasi, iklan dan boilerplate. Kandungan Confluence, Notion dan SharePoint diakses melalui API masing-masing, dengan struktur halaman dan metadata dikekalkan. Repositori kod memerlukan pemecahan khusus yang menghormati sempadan fungsi dan kelas. Fail Markdown dan teks biasa adalah yang paling mudah untuk diproses tetapi masih mendapat manfaat daripada pemecahan yang peka struktur. Prinsip utama ialah setiap jenis dokumen memerlukan strategi penghuraian dan pemecahan yang disesuaikan — saluran paip yang berfungsi dengan baik untuk dokumen teks bersih akan menghasilkan hasil yang buruk pada PDF kompleks dengan jadual dan rajah. Sistem RAG yang teguh termasuk pengesanan jenis dokumen, penghurai khusus untuk setiap jenis, dan pemeriksaan kualiti yang menandakan kegagalan penghuraian sebelum kandungan yang rosak memasuki indeks.
Apakah chunking dan mengapa saiz chunk penting?+
Chunking ialah proses membahagikan dokumen anda kepada kepingan yang lebih kecil yang dibenamkan secara individu dan disimpan dalam pangkalan data vektor. Apabila pengguna bertanya soalan, sistem akan mendapatkan semula cebisan yang paling relevan — bukan keseluruhan dokumen — jadi saiz cebisan secara langsung mempengaruhi ketepatan pengambilan dan kualiti jawapan. Jika cebisan terlalu besar, ia mengandungi terlalu banyak maklumat dan ayat yang relevan dicairkan oleh kandungan sekeliling. Pembenaman mewakili makna purata keseluruhan cebisan, jadi cebisan besar tentang pelbagai topik tidak akan sepadan dengan baik dengan soalan khusus tentang salah satu topik tersebut. Cebisan besar yang diambil juga menggunakan lebih banyak tetingkap konteks model AI, meninggalkan lebih sedikit ruang untuk pelbagai sumber dan gesaan penjanaan. Jika cebisan terlalu kecil, ia kehilangan konteks — satu ayat mungkin tidak mengandungi maklumat yang mencukupi untuk model menjana jawapan yang berguna, dan konteks penting daripada ayat sekeliling hilang. Cebisan yang sangat kecil juga meningkatkan bilangan vektor dalam pangkalan data dan bilangan hasil pengambilan yang diperlukan untuk meliputi topik. Saiz cebisan yang optimum bergantung pada jenis kandungan dan corak soalan anda. Untuk dokumentasi fakta seperti artikel bantuan dan panduan produk, cebisan 200-500 token berfungsi dengan baik kerana maklumat cenderung tertumpu. Untuk kandungan naratif seperti laporan dan analisis, cebisan yang lebih besar iaitu 500-1000 token mengekalkan aliran penaakulan. Pertindihan antara cebisan — biasanya 50-100 token kandungan yang dikongsi pada sempadan cebisan — memastikan maklumat yang dibahagikan merentasi sempadan cebisan masih boleh diambil. Pendekatan yang lebih maju termasuk chunking semantik yang membahagikan pada sempadan topik semula jadi, chunking rekursif yang mencipta perwakilan hierarki, dan chunking ibu-anak di mana cebisan kecil diambil tetapi cebisan induk yang lebih besar dihantar kepada model untuk lebih banyak konteks.
Bagaimanakah cara saya mengurangkan halusinasi dalam sistem RAG?+
Halusinasi dalam sistem RAG berlaku apabila model AI menjana maklumat yang tidak terdapat dalam konteks yang diambil — sama ada mereka-reka fakta, menyalahgambarkan kandungan sumber, atau menggabungkan maklumat yang diambil dengan pengetahuan latihannya sendiri dengan cara yang mengelirukan. Beberapa teknik mengurangkan halusinasi secara sistematik. Tingkatkan ketepatan pengambilan terlebih dahulu — punca halusinasi yang paling biasa bukanlah model tetapi pengambilan yang lemah. Jika dokumen sumber yang betul tidak diambil, model sama ada mengakui ia tidak dapat menjawab, yang merupakan tingkah laku yang diingini, atau menjana jawapan daripada data latihannya, yang merupakan halusinasi. Pemecahan yang lebih baik, carian hibrid, penapisan metadata dan pemilihan model pembenaman semuanya meningkatkan ketepatan pengambilan. Gunakan arahan asas yang jelas dalam arahan sistem anda — arahkan model untuk menjawab hanya daripada konteks yang diberikan, untuk mengatakan ia tidak tahu apabila konteks tidak mengandungi jawapan, dan untuk tidak pernah menambah dengan maklumat daripada data latihannya. Sertakan keperluan petikan — arahkan model untuk memetik sumber dan bahagian tertentu untuk setiap tuntutan, yang memaksanya untuk mengasaskan setiap pernyataan dalam kandungan yang diambil dan menjadikan tuntutan yang direka-reka jelas. Laksanakan pengesahan jawapan — gunakan panggilan AI kedua untuk memeriksa sama ada jawapan yang dijana sebenarnya disokong oleh konteks yang diambil, menandakan atau menapis respons di mana tuntutan tidak dapat dikesan kepada bahan sumber. Tambah pemarkahan keyakinan — minta model untuk menilai keyakinannya bahawa jawapan disokong sepenuhnya oleh konteks yang diberikan. Gunakan ambang skor pengambilan — jika skor kesamaan cebisan yang diambil di bawah ambang, kembalikan respons yang menunjukkan maklumat tidak mencukupi daripada cuba menjawab daripada konteks yang lemah. Dan bina saluran paip penilaian yang sentiasa mengukur kadar halusinasi merentasi soalan ujian dengan jawapan yang diketahui.
Bolehkah saya membina sistem RAG yang sentiasa terkini apabila dokumen saya berubah?+
Ya — sistem RAG pengeluaran memerlukan saluran paip automatik yang mengesan perubahan dokumen dan mengemas kini indeks vektor dengan sewajarnya. Ini adalah salah satu perbezaan kritikal antara sistem RAG demo dan sistem pengeluaran. Pendekatan bergantung pada sumber dokumen anda. Untuk dokumen yang disimpan dalam platform awan seperti Confluence, Notion, SharePoint atau Google Drive, saluran paip pengambilan menggunakan API platform untuk mengesan halaman baharu, diubah suai dan dipadamkan mengikut jadual — biasanya setiap jam atau setiap hari bergantung pada kekerapan kandungan anda berubah. Halaman baharu dipecahkan, dibenamkan dan ditambahkan pada indeks vektor. Halaman yang diubah suai mempunyai cebisan lama mereka dipadamkan dan cebisan baharu dimasukkan. Halaman yang dipadamkan mempunyai cebisan mereka dikeluarkan daripada indeks. Untuk stor dokumen berasaskan fail, saluran paip memantau direktori untuk perubahan fail menggunakan checksum atau cap masa pengubahsuaian. Untuk kandungan web, saluran paip merangkak semula URL sumber mengikut jadual dan membandingkan hash kandungan untuk mengesan perubahan. Keputusan seni bina utama adalah kekerapan penyegerakan — berapa kerap saluran paip memeriksa perubahan — dan ketelitian pengesanan perubahan — sama ada anda memproses semula keseluruhan dokumen atau hanya bahagian yang berubah. Pemprosesan inkremental yang hanya membenamkan semula kandungan yang berubah adalah lebih cekap tetapi lebih kompleks untuk dilaksanakan daripada pengambilan semula penuh. Anda juga perlu mengendalikan kemas kini metadata — apabila tajuk dokumen, pengarang atau kategori berubah, metadata cebisan yang berkaitan dalam pangkalan data vektor perlu dikemas kini. Pakar di Zinn Hub membina saluran paip penyegerakan automatik ini sebagai sebahagian daripada penggunaan RAG pengeluaran supaya pangkalan pengetahuan anda kekal terkini tanpa campur tangan manual.
Bagaimana saya memilih pakar RAG dan pangkalan pengetahuan di Zinn Hub?+
Apabila memilih pakar RAG dan pangkalan pengetahuan di Zinn Hub, cari pengalaman yang terbukti dalam membina sistem RAG hujung ke hujung — bukan hanya kejuruteraan segera atau antara muka chatbot. RAG melibatkan pelbagai domain teknikal termasuk pemprosesan dokumen, model pembenaman, pangkalan data vektor, algoritma perolehan, kejuruteraan segera dan penilaian, dan pakar memerlukan kedalaman merentasi kesemuanya. Semak portfolio mereka untuk projek RAG yang mengendalikan jenis dan volum dokumen yang serupa dengan anda. Jika anda mempunyai PDF yang kompleks dengan jadual dan imej, sahkan mereka mempunyai pengalaman dengan cabaran penghuraian khusus tersebut. Jika anda memerlukan pengambilan berbilang sumber daripada Confluence, SharePoint atau pangkalan data, semak pengalaman dengan integrasi khusus tersebut. Baca ulasan pembeli untuk maklum balas mengenai ketepatan jawapan, kualiti perolehan, kebolehpercayaan sistem dan dokumentasi. Tanya tentang pendekatan chunking dan pembenaman mereka — pakar yang baik akan membincangkan pertukaran antara strategi chunking dan mengesyorkan pendekatan berdasarkan jenis kandungan anda dan bukannya menggunakan kaedah satu saiz untuk semua. Tanya bagaimana mereka mengukur kualiti — jurutera RAG profesional membina set penilaian dengan soalan yang diketahui dan jawapan yang dijangkakan serta mengukur ketepatan perolehan, ketepatan jawapan dan kadar halusinasi secara kuantitatif. Tanya tentang pendekatan mereka untuk pencegahan halusinasi — arahan asas, penjanaan petikan, pemarkahan keyakinan dan langkah pengesahan. Tanya apa yang disertakan dalam sistem mereka untuk penyelenggaraan berterusan — pengindeksan semula automatik, papan pemuka pemantauan, penjejakan ketepatan dan konfigurasi amaran. Untuk penggunaan perusahaan, sahkan pengalaman dengan kawalan akses, berbilang penyewa, pengelogan audit dan keperluan pematuhan. Hantar mesej kepada pakar sebelum membuat pesanan untuk membincangkan sumber dokumen anda, volum, jenis soalan dan keperluan ketepatan.