
プライベートなローカルAI LLMを展開し、あなたのハードウェア上でPython自動化を構築します
Ollamaを使用して、プライベートなローカルLLM(Qwen/Llama)をお客様のPCにインストールします。100%オフラインで安全です。
- ローカルLLMセットアップ
- ドキュメント付属
- 100%オフライン&プライベート
基本機能のすべてに加え、クリーンなWeb UI(Open WebUI)とカスタムPython自動化スクリプトが含まれます。
- 基本のすべて
- Web UI付属
- カスタムPythonスクリプト
- 優先サポート
標準機能のすべてに加え、高度なハードウェア最適化、複雑なPython自動化、1対1の技術サポートが含まれます。
- スタンダードのすべて
- ハードウェア最適化
- 高度な自動化
- 1対1サポート
カスタムオファーをリクエストする
カスタムオファーをリクエストするにはログインしてください
無料アカウントを作成するか、ログインして、この Zinner からパーソナライズされたオファーをリクエストしてください。
ログイン / 登録購入前のご質問をお問い合わせください
質問をするにはログインしてください
プラットフォームのスパムを減らすため、販売前メッセージはログイン済みユーザーのみが送信できます。
無料アカウントを作成するか、ログインしてこの Zinner に直接メッセージを送信してください。
ログイン / 登録一目でわかる
このサービスについての重要な詳細情報です。Zinn Hubによって生成されました。売り手によるものではありません。
価値ポジション
デプロイ方法
サポートされているモデル
プライバシーレベル
配送とサポート
受け取るもの
完全な説明
OpenAIやAnthropicに高額な月額料金を支払うのにうんざりしていませんか?
機密性の高いビジネスデータがクラウドに送信されることを心配していませんか?
こんにちは、私はDSEcho Studio (www.dsecho.cn)の創設者、Deep Stace Echoです。私は100%プライベート、オフライン、自己ホスト型AIシステムの構築を専門とするハードコアなフルスタック開発者です。
私と協力すれば、お客様自身のハードウェア上で完全に動作するシステムを手に入れることができます。インターネットは不要で、データ漏洩もなく、月額API料金もゼロです。
得られるもの:
1. ローカルAI&LLMデプロイメント
Ollamaを使用して、最先端のオープンソースモデル(QwenやLlamaなど)をお客様のPC、Mac、またはサーバーに直接デプロイし、最適化します。ハイエンドGPUをお持ちの場合でも、CPUのみの場合でも、スムーズに動作するように適切なモデルと量子化形式を設定します。
2. カスタムAIエージェントフレームワーク
私は単に基本的なチャットボットをインストールするだけではありません。高度な機能を備えたインテリジェントなAIエージェントを構築します。
-
バイオニックメモリシステム: AIが長い会話を記憶し、従来のコンテキストウィンドウの制限を回避できるようにします。
-
自律ツール生成: AIが独自のPythonスクリプトを作成・実行し、複雑なタスクを自動的に解決できます。
3. Python自動化&スクリプト作成
ウェブデータのスクレイピング、Excelファイルの処理、反復的なワークフローの自動化が必要ですか?私は、詳細なドキュメント付きで、クリーンで非常に効率的なPythonスクリプトを作成し、お客様が簡単に保守できるようにします。
私のプロセス:
-
議論: お客様のハードウェア仕様と目標を私にメッセージで伝えてください。
-
デプロイメント: 環境をセットアップし、モデルをダウンロードし、設定をリモートで行うか、ワンクリックスクリプトを提供します。
-
テスト&納品: システムを一緒にテストします。AIの使用方法と更新方法を正確に理解できるように、ステップバイステップのREADME(ドキュメント)を提供します。
私を選ぶ理由
-
直接コミュニケーション: コードを書く開発者と直接話すことができます。仲介業者や代理店は介しません。
-
クリーンで文書化されたコード: ブラックボックスではなく、真の価値を提供します。
-
迅速な配送: ほとんどのデプロイメントタスクは24〜48時間以内に完了します。
クラウドに頼るのはやめましょう。今日からあなた自身のプライベートAIインフラストラクチャを構築しましょう!
ご注文前にメッセージをください。お客様の正確な要件について話し合い、完璧に適合することを確認できます。
Zinner クオリティ保証
すべての Zinner はプラットフォームに参加する前に審査・承認されます。
すべてのサービスは、当社の品質保証コミットメントによってサポートされています。
納品された作業を承認するまで、お客様の支払いは保護されます。
パッケージを比較
| 特徴 | ベーシック | 標準AIエージェント&自動化 | プレミアムカスタムAI&フルスタック |
|---|---|---|---|
| 納期 | 2 日 | 3 日 | 5 日 |
| リビジョン | 1 | 2 | 3 |
| ローカルLLMセットアップ | ✓ | ✕ | ✕ |
| ドキュメント付き | ✓ | ✕ | ✕ |
| 100%オフライン&プライベート | ✓ | ✕ | ✕ |
| 基本のすべて | ✕ | ✓ | ✕ |
| Web UI付属 | ✕ | ✓ | ✕ |
| カスタムPythonスクリプト | ✕ | ✓ | ✕ |
| 優先サポート | ✕ | ✓ | ✕ |
| スタンダードのすべて | ✕ | ✕ | ✓ |
| ハードウェア最適化 | ✕ | ✕ | ✓ |
| 高度な自動化 | ✕ | ✕ | ✓ |
| 1対1サポート | ✕ | ✕ | ✓ |
ポートフォリオ
このZinnに関連するセラーの作品の例。
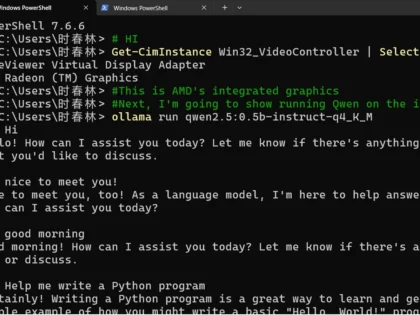
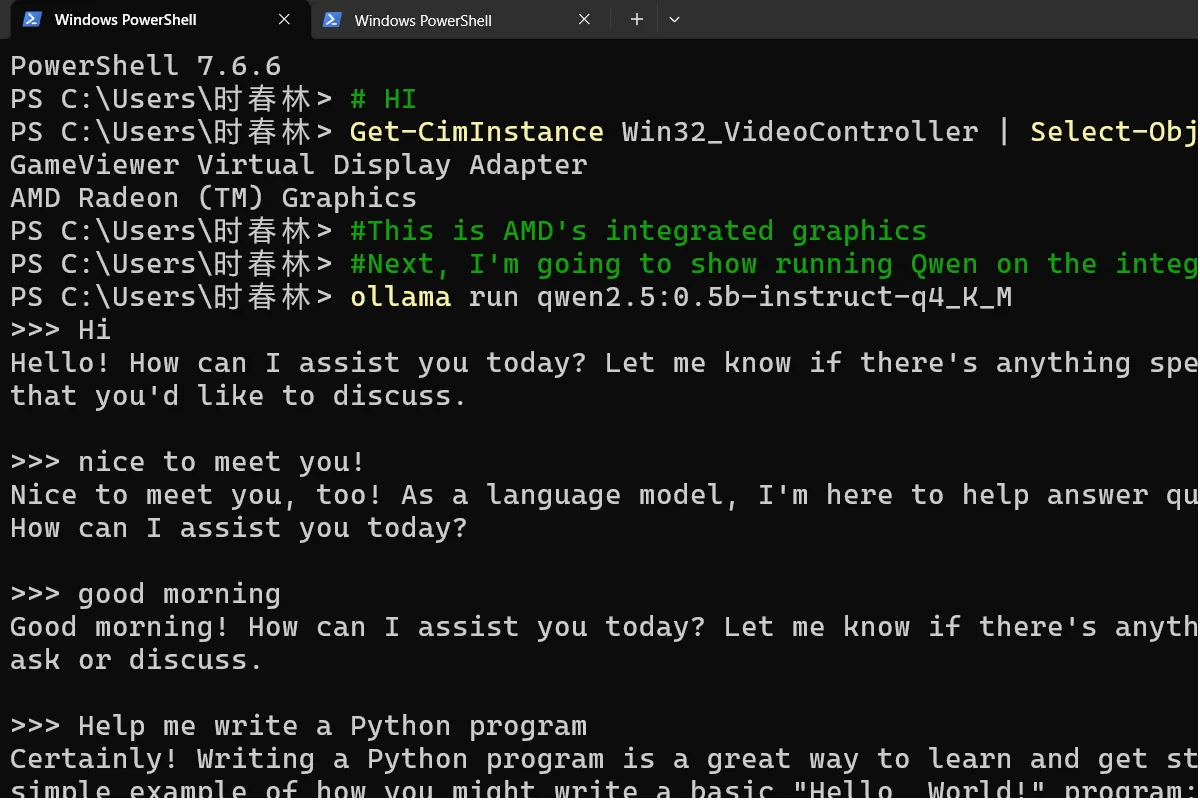
AMD統合グラフィックス(iGPU)でAIモデルを実行
ローカルLLMを実行したいが、NVIDIA GPUを持っていない?VulkanやROCmなどのテクノロジーを使用して、AMD統合グラフィックスにAIモデル(Qwen/Llamaなど)を直接デプロイして最適化できます。100%オフラインでプライベートです。
サービス詳細
よくある質問
ご注文前にメッセージを送ってください!CPU/GPUとRAMを分析し、どの量子化モデル(4ビットまたは8ビットバージョンなど)がマシンでスムーズに動作するかを判断します。ハードウェアがローカルLLMを実行できない場合は、全額返金されます。
もちろんです。セットアップが完了し、モデルがダウンロードされたら、インターネットケーブルを抜いてもAIは完璧に動作します。データがマシンから離れることはないので、機密性の高いビジネス文書に最適です。
顧客レビュー
このZinnについてお客様の声をご覧ください