

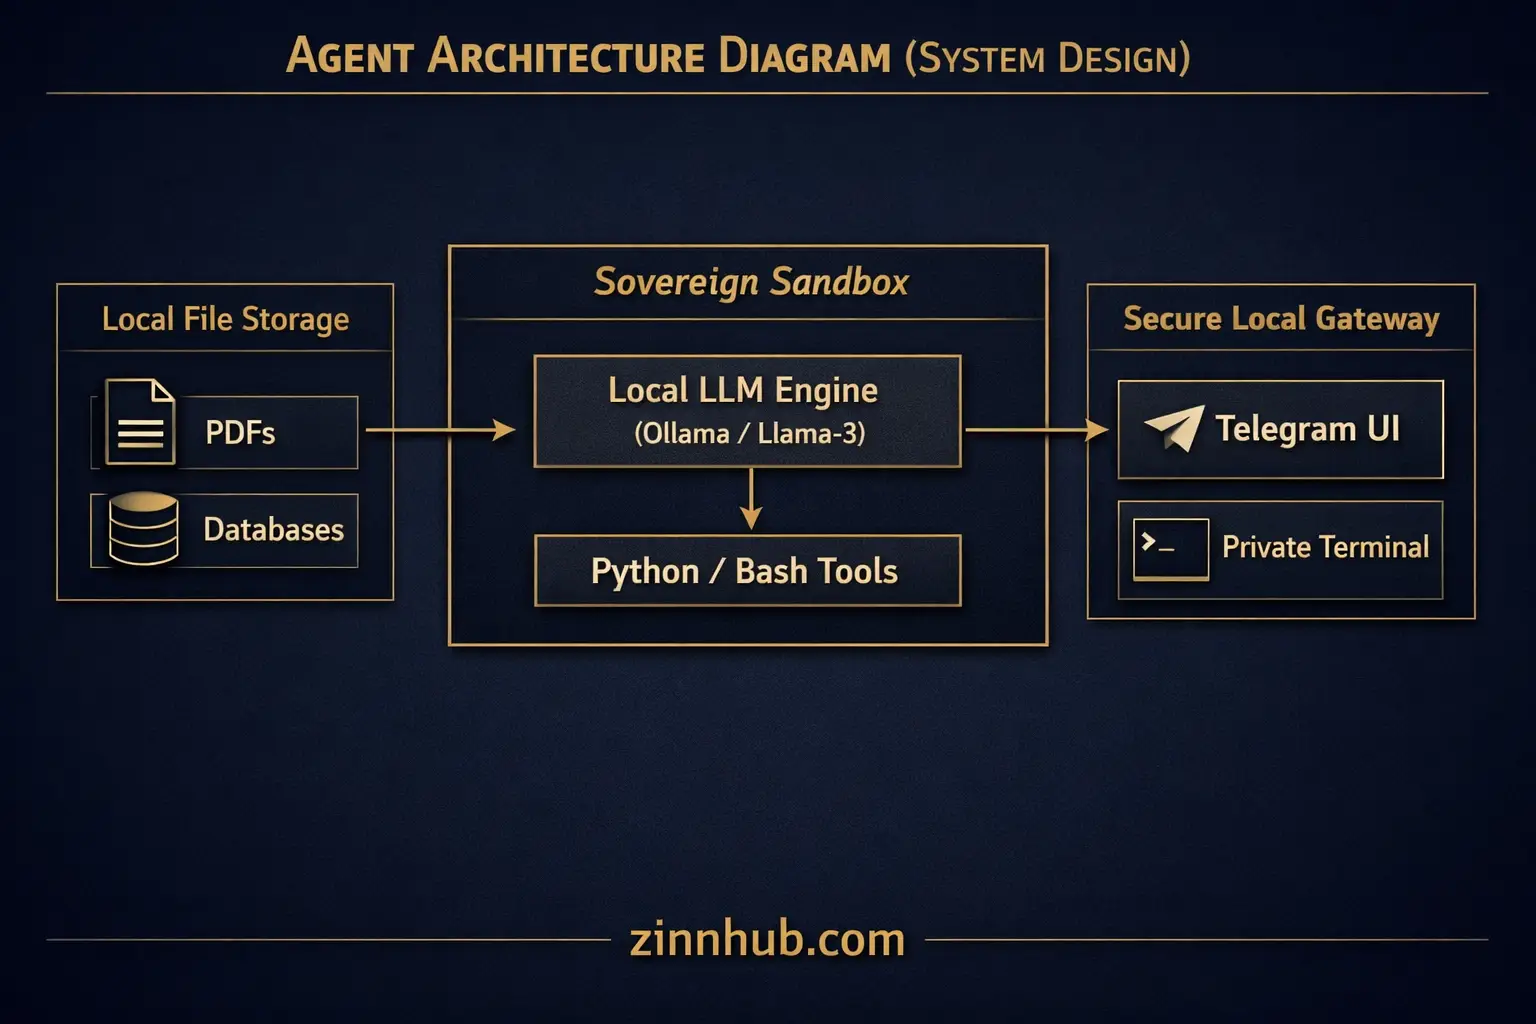
ローカルLLMとRAGパイプラインを実行するには、ハードウェアリソースの正確なバランスが必要です。モデルパラメータが利用可能なGPU VRAMまたはシステムRAMを超えると、OSがシステムストレージを使用せざるを得なくなるため、実行速度がほぼゼロに低下します。これは…
一目でわかる
このサービスについての重要な詳細情報です。Zinn Hubによって生成されました。売り手によるものではありません。
価値ポジション
受け取るもの
高速納期
提供する必要があるもの
最適な用途
完全な説明
ローカルLLMとRAGパイプラインを実行するには、ハードウェアリソースの正確なバランスが必要です。モデルパラメータが利用可能なGPU VRAMまたはシステムRAMを超えると、OSがシステムストレージの使用を余儀なくされるため、実行速度はほぼゼロに低下します。
このMicro Zinnは、ソフトウェアを購入またはインストールする前に、ハードウェアの完全な互換性監査を提供します。Apple Silicon Mac、NVIDIA CUDAワークステーション、または標準的なWindows/Linuxサーバーなど、物理システムを評価して、最適なローカルパフォーマンスを実現する方法を正確にお知らせします。
分析内容:
1. GPU VRAMの制約: 専用グラフィックメモリをマッピングして、最大モデルパラメータ上限(例: 7B、13B、または34Bモデル)を特定します。
2. システムRAMの割り当て: 専用GPUがない場合や共有システムメモリで実行している場合、CPU推論のしきい値とオフロード制限を決定します。
3. 量子化マッピング: 処理速度とモデルのインテリジェンスのバランスを取るために、正確な量子化レベル(Q4_K_M、Q5_K_M、またはQ8_0など)を推奨します。
4. コンテキストウィンドウの制限: 大量のドキュメント検索中にシステムがメモリ不足でクラッシュするのを防ぐため、安全な最大トークン制限を計算します。
ダウンロードすべきオープンソースのウェイトや、ローカルセットアップが遅い理由を推測するのはやめましょう。これらのシステムを物理的な金属で日々構築しているオペレーターから、ローカルAI環境向けのエンジニアリングされたハードウェア固有のマップを入手してください。
Ollamaモデルのパラメータ制限、コンテキストウィンドウのスケール、128GB RAMに最適なQ4/Q5量子化をマッピングするハードウェア互換性監査を完了しました。
例を表示 ↗Micro Zinnは、少額の固定価格で提供されるお試しサービスまたはマイクロサービスです。CAVOK_Designsはこれを以下の目的で提供しています。
スキル紹介ポートフォリオビルダー新規クライアント受付中Zinner クオリティ保証
すべての Zinner はプラットフォームに参加する前に審査・承認されます。
すべてのサービスは、当社の品質保証コミットメントによってサポートされています。
納品された作業を承認するまで、お客様の支払いは保護されます。
顧客レビュー
このZinnについてお客様の声をご覧ください

