RAG&ナレッジベーススペシャリストを雇う
組織の知識は、AIモデルがデフォルトでアクセスできないドキュメント、Wiki、データベース、ファイルシステムにロックされています。そして、特定のデータから質問に正確に答えるAIシステムを構築する唯一の方法は、検索拡張生成(RAG)です。RAGは、汎用AIモデルをビジネスのエキスパートに変えるアーキテクチャであり、クエリ時にドキュメントに接続することで、一般的な応答や幻覚情報ではなく、根拠のある正確で引用可能な回答を提供するために必要なコンテキストを与えます。
Zinn Hubでは、経験豊富なAIエンジニアがカスタムRAGパイプライン、ベクトルデータベースシステム、ドキュメント取り込みワークフロー、ナレッジベースチャットボット、ハイブリッド検索実装、評価フレームワークを構築し、組織の知識を自然言語で検索可能にします。彼らは、ドキュメント解析、チャンキング戦略、埋め込みモデル、ベクトルデータベース、検索アルゴリズム、グラウンデッド生成のためのプロンプトエンジニアリング、そして信頼できるシステムと信頼できないシステムを区別する評価方法論といったRAGスタック全体を理解しているスペシャリストです。すべてのリスティングで暗号通貨で支払い、最初の500ドルは手数料無料です。
RAGがビジネスにとって重要である理由
すべての組織は知識の問題を抱えています。重要な情報は、ドキュメント、ポリシー、ヘルプ記事、社内Wiki、Slackスレッド、メールアーカイブ、個人の専門知識に散らばっています。従業員は、組織内のどこかに存在するが探しにくい答えを探すのに何時間も費やします。顧客は、エージェントが手動でナレッジベースを検索している間、サポートの返信を待ちます。新しいチームメンバーは、組織の知識が文書化されていないか埋もれているため、立ち上がるのに数ヶ月かかります。RAGはこれを解決します。既存の知識の上にAIレイヤーを作成し、誰でも自然言語でクエリできるようにします。何十ものドキュメントを検索し、適切なキーワードが一致することを期待する代わりに、ユーザーは自然に質問し、ソースドキュメントを指す引用付きの正確な回答を受け取ります。AIは推測しません。データから関連する箇所を取得し、その証拠に基づいて回答を生成します。これは、特定のビジネスについて何も知らないChatGPTに従業員がアクセスできるようにすることとは根本的に異なります。ドキュメントでトレーニングされたRAGシステムは、製品、プロセス、ポリシー、手順に関する常に利用可能なエキスパートとなり、一貫して回答し、決して忘れず、組織内のすべての人に同時にサービスを提供するために拡張できます。
Zinn HubのRAG&ナレッジベースサービス
- カスタムRAGパイプライン開発 — ドキュメントをAIモデルに接続するエンドツーエンドの検索拡張生成システム。ドキュメントの取り込み、チャンキング、埋め込み、ベクトルストレージ、検索、プロンプトエンジニアリング、引用サポート付きの回答生成。
- ベクターデータベースのセットアップと構成 — Pinecone、Weaviate、Qdrant、Milvus、ChromaDB、またはpgvectorのインストール、スキーマ設計、インデックス戦略、メタデータフィルタリング、ネームスペース構成、クエリパフォーマンス最適化。
- ドキュメント取り込みパイプライン — PDF、Word文書、スプレッドシート、ウェブページ、Confluence、Notion、SharePoint、Google Drive、その他のソースを、チャンク化、埋め込み、インデックス化されたコンテンツに自動処理し、変更検出と増分再インデックス化を行います。
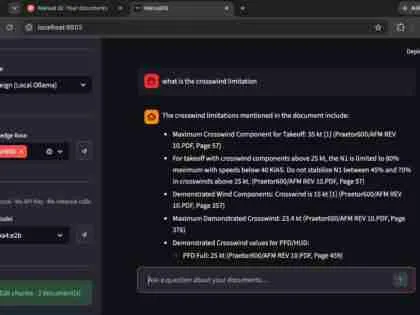
- AI搭載ドキュメントQ&Aシステム — ユーザーが自然言語で質問し、引用、信頼度スコア、ソース資料へのリンク付きでドキュメントから正確な回答を受け取るチャットまたは検索インターフェース。
- ナレッジベースチャットボット — ブランド化されたインターフェース、会話履歴、フィードバック収集機能を備え、ナレッジベース、製品ドキュメント、ヘルプセンター、SOP、ポリシー文書からの質問に答える顧客向けまたは社内AIアシスタント。
- ハイブリッド検索の実装 — ベクトル類似性検索とBM25キーワード検索を組み合わせることで、純粋なベクトル検索では見逃される可能性のある意味的意味と正確な専門用語、技術用語、固有名詞の両方を処理する検索を実現します。
- チャンキング戦略の最適化 — 固定サイズ、セマンティック、再帰的、親子チャンキングアプローチをコンテンツタイプに対して体系的にテストし、定量化された精度比較により最適な戦略を決定します。
- 埋め込みモデルの選択とファインチューニング — OpenAI、Cohere、Voyage、BGE、E5、その他の埋め込みモデルをデータに対してベンチマークします。検索の関連性を向上させるために、ドメインの語彙でオプションのファインチューニングを行います。
- マルチモーダルRAGシステム — テキストに加えて画像、図、グラフ、表からの検索により、AIがドキュメントに埋め込まれた視覚コンテンツに関する質問に答えることができます。
- RAG評価と監視 — 検索精度、回答の正確性、幻覚率、応答品質を測定する自動評価パイプライン。精度追跡、遅延メトリック、使用状況分析を備えた本番監視ダッシュボード。
RAGアーキテクチャ層
本番環境のRAGシステムには、それぞれ回答の品質に影響を与える複数の技術レイヤーが含まれています。インジェスト層は、ドキュメントの解析、クリーニング、チャンク化を処理します。埋め込み層は、テキストチャンクをベクトル表現に変換します。ストレージ層(ベクトルデータベース)は、高速な類似性検索のためにこれらのベクトルをインデックス化し、提供します。検索層は、検索戦略を組み合わせ、フィルターを適用し、結果をランク付けします。生成層は、プロンプトエンジニアリングを使用して、取得されたコンテキストに基づいてAIモデルの応答を根拠付けます。そして、評価層は、エンドツーエンドの品質を測定します。いずれかの層に弱点があるとシステム全体が劣化するため、RAGには単一のコンポーネントだけでなく、フルスタックを理解している専門家が必要です。
関連サービス
RAGとナレッジベースの開発は、Zinn Hubの他のAIおよび開発サービスと連携しています。RAGシステムの生成レイヤーを強化するプロンプトについては、プロンプトエンジニアリングサービスを参照してください。RAGクエリをトリガーし、結果を処理する自動ワークフローについては、AI自動化とワークフローサービスを参照してください。コードなしでRAGを活用したインターフェースを構築するには、ノーコードおよびローコード開発を検討してください。RAGを補完するカスタムAIモデルのトレーニングとファインチューニングについては、AI開発親カテゴリを参照してください。自己管理型ベクトルデータベースとRAGパイプラインをホストするサーバーインフラストラクチャについては、Linuxサーバー管理を参照してください。RAGシステムのデプロイパイプラインとInfrastructure-as-Codeについては、DevOpsエンジニアリングサービスを参照してください。
経験豊富なRAGエンジニアですか?Zinn HubでRAGおよびナレッジベースサービスの販売を開始し、カスタム検索拡張生成システム、ベクトルデータベースの専門知識、AIを活用したドキュメント検索を必要とする世界中の企業とつながりましょう。無料でZinnerとして登録して、今日から出品を開始してください。
RAGとナレッジベースのスペシャリストを雇う方法
データソースとユースケースを定義する AIシステムが検索する必要があるドキュメントとデータを特定します — PDF、ヘルプ記事、Wiki、データベース、ウェブページ、または内部ドキュメント。ユーザーがシステムとどのように対話するかを定義し、精度要件と予想される質問タイプを指定します。
RAGスペシャリストを選ぶ Zinn HubでRAGおよびナレッジベースサービスを閲覧します。ドキュメントの種類、データ量、デプロイ環境に関する経験についてポートフォリオを確認します。回答の正確性とシステムの信頼性について購入者のレビューを確認します。スペシャリストにメッセージを送信して要件を話し合います。
ドキュメントとアクセスを提供する ドキュメントコレクションを共有するか、コンテンツプラットフォームへのAPIアクセスを提供します。評価用のサンプル質問、期待される回答、およびドメイン固有の用語を提供します。異なるユーザーが異なるコンテンツを見る必要がある場合は、アクセス制御要件を指定します。
評価、デプロイ、監視 検索精度、回答の正確性、幻覚率を示す評価結果を確認します。実際のユーザーとエッジケースでテストします。精度、使用状況、パフォーマンスを追跡する監視ダッシュボードでデプロイします。完全なアーキテクチャドキュメントとメンテナンス手順を受け取ります。
RAGとナレッジベースに関するよくある質問
Zinn HubでどのようなRAGおよびナレッジベースサービスを購入できますか?+
Zinn Hubは、経験豊富なAIエンジニアによるRAGおよびナレッジベース開発サービスの全範囲を提供しています。カスタムRAGパイプライン開発を購入できます。これは、ドキュメント、データベース、知識源をAIモデルに接続し、特定のデータを使用して質問に正確に答えるエンドツーエンドの検索拡張生成システムです。ベクトルデータベースのセットアップと構成。Pinecone、Weaviate、Qdrant、Milvus、ChromaDB、またはpgvectorのインストール、スキーマ設計、インデックス戦略、メタデータフィルタリング、クエリ最適化。ドキュメント取り込みパイプライン。PDF、Wordドキュメント、スプレッドシート、Webページ、Confluence wiki、Notionデータベース、SharePointライブラリ、その他のソースをチャンク化、埋め込み、インデックス付けされたコンテンツに処理し、検索準備を整えます。AI搭載ドキュメントQ&Aシステム。ユーザーが自然言語で質問し、引用付きでドキュメントから直接正確な回答を受け取るチャットボットまたは検索インターフェース。ナレッジベースチャットボット。顧客向けまたは社内AIアシスタントで、ナレッジベース、製品ドキュメント、ヘルプセンター記事、SOP、ポリシー文書からの質問に答えます。ハイブリッド検索の実装。ベクトル類似性検索とBM25を使用した従来のキーワード検索を組み合わせ、意味的意味と正確な用語の両方を処理する検索を実現します。チャンキング戦略の最適化。コンテンツタイプに適したドキュメント分割アプローチをテストおよび実装し、最適な検索精度を実現するためにチャンクサイズ、オーバーラップ、メタデータ保持のバランスを取ります。埋め込みモデルの選択とファインチューニング。ドメインとコンテンツタイプに適した埋め込みモデルを選択し、代替モデルをベンチマークし、オプションでデータ上で埋め込みをファインチューニングして検索関連性を向上させます。マルチモーダルRAGシステム。テキストに加えて画像、図、表、グラフに対する検索で、AIがドキュメント内の視覚コンテンツに関する質問に答えることを可能にします。そしてRAGの評価と監視。検索精度、回答の正確性、幻覚率、応答品質を自動スコアリングで測定する評価パイプラインを構築します。
Zinn HubでのRAGおよびナレッジベースサービスの費用はいくらですか?+
費用は、RAGアーキテクチャの複雑さ、ソースドキュメントの量と多様性、および必要な精度レベルによって異なります。単一のドキュメントコレクション(最大500ページ)を取り込むシンプルなチャットインターフェースを備えた基本的なRAGシステムは、500ドルから1500ドルかかります。複数のドキュメントソース、ハイブリッド検索、メタデータフィルタリング、引用生成、洗練されたチャットUIを備えた本番RAGパイプラインは、1500ドルから5000ドルかかります。スキーマ設計、インデックス最適化、クエリチューニングを含むベクトルデータベースのセットアップと構成は、300ドルから1000ドルかかります。Confluence、Notion、SharePoint、またはその他のプラットフォームからのコンテンツを自動同期で処理するドキュメント取り込みパイプラインは、500ドルから2000ドルかかります。ブランド化されたインターフェース、会話履歴、フィードバック収集、分析機能を備えた顧客向けナレッジベースチャットボットは、1000ドルから4000ドルかかります。ベクトル検索とキーワード検索を関連性チューニングと組み合わせたハイブリッド検索の実装は、500ドルから1500ドルかかります。複数のアプローチにわたる体系的なテストと定量化された精度比較によるチャンキング戦略の最適化は、300ドルから1000ドルかかります。特定のコンテンツドメイン向け埋め込みモデルのベンチマークと選択は、300ドルから800ドルかかります。複数のデータソース、ロールベースのアクセス制御、監査ログ、評価パイプライン、継続的な監視を備えた包括的なエンタープライズRAGシステムは、3000ドルから10000ドルかかります。再インデックス作成、精度監視、プロンプト更新、ソース同期を含む継続的な月額メンテナンスは、通常月額200ドルから800ドルです。
RAGとは何ですか?どのように機能しますか?+
RAG(Retrieval Augmented Generation)は、AI言語モデルを特定のデータに接続するアーキテクチャであり、トレーニングデータのみに依存するのではなく、ドキュメント、データベース、知識源からの情報を使用して質問に正確に回答できるようにします。RAGがない場合、AIモデルはトレーニング中に学習した内容に基づいてのみ応答でき、内部ドキュメント、製品仕様、会社の方針、顧客データ、またはトレーニングセットに含まれていなかった情報にアクセスすることはできません。RAGは、生成の前に検索ステップを追加することでこれを解決します。このプロセスは3つの段階で機能します。まず、取り込みフェーズ中にドキュメントが処理されます。ドキュメントはチャンクに分割され、各チャンクは埋め込みモデルを使用して埋め込みと呼ばれる数値表現に変換され、これらの埋め込みは元のテキストとメタデータとともにベクトルデータベースに保存されます。次に、ユーザーが質問をすると、その質問も埋め込みに変換され、質問の埋め込みに最も類似したチャンクがベクトルデータベースで検索されます。これはセマンティック検索であり、キーワードマッチングではなく意味によってコンテンツを見つけます。第三に、最も関連性の高いチャンクが取得され、ユーザーの質問とともにコンテキストとしてAIモデルに渡され、モデルはその取得されたコンテンツに基づいて回答を生成します。その結果、特定のデータを使用して質問に正確に回答し、情報源を引用でき、ドキュメントが更新されると最新の状態を保ち、記憶ではなく取得された証拠から生成するため情報を幻覚しないAIシステムが実現します。
ベクトルデータベースとは何ですか?また、RAGにベクトルデータベースが必要なのはなぜですか?+
ベクトルデータベースは、埋め込みモデルによって作成されたテキスト、画像、その他のコンテンツの数学的表現である高次元の数値ベクトルを保存および検索するために設計された特殊なデータベースです。従来のデータベースは、完全一致またはキーワードパターンで検索します。ベクトルデータベースは類似性で検索します。クエリベクトルが与えられると、たとえまったく異なる単語を使用していても、意味的に最も近い保存されたベクトルを見つけます。RAGにはベクトルデータベースが必要です。なぜなら、セマンティック検索が検索を機能させるためのコアメカニズムだからです。ユーザーがドキュメントについて質問すると、システムはキーワードを一致させるのではなく、意味を理解することによって最も関連性の高い箇所を見つける必要があります。返品ポリシーに関する質問は、クエリに「返品」という正確な単語が含まれていなくても、返品に関するドキュメントを見つける必要があります。ベクトルデータベースは、何百万ものドキュメントチャンクにわたっても、この類似性検索を高速かつスケーラブルにします。人気のあるベクトルデータベースには、シンプルなAPIアクセスと自動スケーリングを備えたフルマネージドクラウドサービスであるPineconeがあります。ベクトルとキーワード検索を組み合わせた組み込みのハイブリッド検索を備えたオープンソースのWeaviate。強力なフィルタリング機能と効率的なメモリ使用量を備えたオープンソースのQdrant。軽量で開発者に優しく、プロトタイピングや小規模なデプロイメントに理想的なChromaDB。大規模なエンタープライズデプロイメント向けに設計されたオープンソースのMilvus。そして、既存のPostgreSQLデータベースにベクトル検索を追加し、別のシステムを必要としないPostgreSQL拡張機能であるpgvectorがあります。選択は、規模、インフラストラクチャの好み、マネージドかセルフホストか、ハイブリッド検索、マルチテナンシー、高度なフィルタリングなどの機能が必要かどうかに依存します。
RAGとAIモデルのファインチューニングの違いは何ですか?+
RAGとファインチューニングは異なる問題を解決し、しばしば混同されます。ファインチューニングは、追加データでAIモデル自体をトレーニングすることでモデルを修正します。モデルは新しいパターン、書き方、またはドメイン知識を永続的に学習します。RAGはモデルを修正しません。外部の知識ベースからクエリ時に関連するコンテキストを提供し、モデルはそのコンテキストに基づいて回答を生成します。ファインチューニングは、モデルに特定の書き方、トーン、またはフォーマットを教えるのに最適です。ドメイン固有の用語や推論パターンをモデルに組み込むためです。一般的な指示をモデルの重みにエンコードすることでプロンプトの長さを短縮するためです。そして、必要な知識が安定しており、頻繁に変化しないタスクに最適です。RAGは、大規模で進化するドキュメントコレクションからの質問に答えるのに最適です。ソース情報が頻繁に変化し、最新の状態を保つ必要があるタスクに最適です。特定のソースドキュメントに遡ることができる、引用された検証可能な回答を提供するためです。モデルトレーニングに含めるべきではない独自の機密データで作業するためです。そして、スタイルの適応よりも精度と根拠が重要なタスクに最適です。実際には、RAGはほとんどのビジネス知識ベースおよびドキュメントQ&Aアプリケーションにとって正しい選択です。なぜなら、情報が時間とともに変化し、ユーザーはソースに対して回答を検証する必要があり、コンテンツの量が多すぎて経済的にモデルにファインチューニングできないからです。両方のアプローチを組み合わせることもできます(RAGも使用するファインチューニングされたモデル)が、ほとんどの実装はRAG単独で開始します。なぜなら、モデルトレーニングのコストと複雑さなしに即座に価値を提供するからです。
RAGシステムで異なるドキュメントタイプをどのように処理すればよいですか?+
現実世界のナレッジベースには、それぞれ異なる取り込みアプローチを必要とする多様なドキュメントタイプが含まれています。PDFは最も一般的で最も困難なもので、テキスト、表、画像、ヘッダー、フッター、複数列レイアウト、スキャンされたページを含むことができます。テキストベースのPDFは、PyMuPDF、pdfplumber、Unstructuredなどのライブラリで解析され、表や複数列レイアウトには特別な処理が必要です。スキャンされたPDFは、テキストをチャンク化して埋め込む前に、TesseractやクラウドOCRサービスなどのツールでOCRが必要です。Wordドキュメントは、python-docxまたは同様のライブラリで解析され、ドキュメントの階層を尊重するインテリジェントなチャンク化のために見出し構造が保持されます。スプレッドシートは、行またはセクションを自然言語の説明または埋め込みモデルが意味のある方法で処理できる構造化テキスト表現に変換する必要があります。Webページはスクレイピングされ、ナビゲーション、広告、定型文を削除しながら主要なコンテンツを抽出するためにクリーンアップされます。Confluence、Notion、SharePointのコンテンツは、それぞれのAPIを通じてアクセスされ、ページ構造とメタデータが保持されます。コードリポジトリは、関数とクラスの境界を尊重する特殊なチャンク化が必要です。Markdownとプレーンテキストファイルは処理が最も簡単ですが、構造を意識したチャンク化の恩恵を受けます。重要な原則は、各ドキュメントタイプには、カスタマイズされた解析およびチャンク化戦略が必要であるということです。クリーンなテキストドキュメントでうまく機能するパイプラインは、表や図を含む複雑なPDFでは不十分な結果を生み出します。堅牢なRAGシステムには、ドキュメントタイプ検出、各タイプに特化したパーサー、および破損したコンテンツがインデックスに入る前に解析の失敗を検出する品質チェックが含まれます。
チャンキングとは何ですか?チャンクサイズが重要なのはなぜですか?+
チャンキングとは、ドキュメントを個別に埋め込み、ベクトルデータベースに保存される小さな断片に分割するプロセスです。ユーザーが質問をすると、システムはドキュメント全体ではなく、最も関連性の高いチャンクを取得するため、チャンクサイズは取得精度と回答品質の両方に直接影響します。チャンクが大きすぎると、情報が多すぎて、関連する文が周囲のコンテンツによって薄められてしまいます。埋め込みはチャンク全体の平均的な意味を表すため、複数のトピックに関する大きなチャンクは、それらのトピックの1つに関する特定の質問と適切に一致しません。取得された大きなチャンクは、AIモデルのコンテキストウィンドウも多く消費し、複数のソースと生成プロンプトのためのスペースが少なくなります。チャンクが小さすぎると、コンテキストが失われます。単一の文では、モデルが有用な回答を生成するのに十分な情報が含まれていない可能性があり、周囲の文からの重要なコンテキストが失われます。非常に小さなチャンクは、データベース内のベクトルの数と、トピックをカバーするために必要な取得結果の数も増加させます。最適なチャンクサイズは、コンテンツの種類と質問のパターンによって異なります。ヘルプ記事や製品ガイドのような事実に基づいたドキュメントの場合、情報が集中している傾向があるため、200〜500トークンのチャンクがうまく機能します。レポートや分析のような物語コンテンツの場合、500〜1000トークンの大きなチャンクは推論の流れを維持します。チャンク間の重複(通常、チャンク境界で50〜100トークンの共有コンテンツ)は、チャンク境界をまたいで分割された情報が依然として取得可能であることを保証します。より高度なアプローチには、自然なトピック境界で分割するセマンティックチャンキング、階層表現を作成する再帰的チャンキング、小さなチャンクが取得されるが、より多くのコンテキストのために大きな親チャンクがモデルに渡される親子チャンキングなどがあります。
RAGシステムでの幻覚を減らすにはどうすればよいですか?+
RAGシステムにおけるハルシネーションは、AIモデルが取得されたコンテキストに存在しない情報を生成するときに発生します。これは、事実を捏造したり、ソースコンテンツを誤って伝えたり、取得された情報と自身のトレーニング知識を誤解を招く方法でブレンドしたりすることです。いくつかの手法により、ハルシネーションを体系的に削減できます。まず、取得精度を向上させます。ハルシネーションの最も一般的な原因はモデルではなく、取得の不備です。正しいソースドキュメントが取得されない場合、モデルは回答できないことを認めるか(これは望ましい動作です)、またはトレーニングデータから回答を生成します(これがハルシネーションです)。より良いチャンキング、ハイブリッド検索、メタデータフィルタリング、埋め込みモデルの選択はすべて、取得精度を向上させます。システムプロンプトで明示的な根拠付け指示を使用します。モデルに、提供されたコンテキストからのみ回答すること、コンテキストに回答が含まれていない場合はわからないと答えること、トレーニングデータからの情報で補足しないことを指示します。引用要件を含めます。モデルに、すべての主張について特定のソースとセクションを引用するように指示します。これにより、各ステートメントを取得されたコンテンツに根拠付けることが強制され、捏造された主張が明らかになります。回答検証を実装します。2回目のAI呼び出しを使用して、生成された回答が実際に取得されたコンテキストによってサポートされているかどうかを確認し、主張がソース資料にたどれない応答にフラグを立てたりフィルタリングしたりします。信頼度スコアリングを追加します。モデルに、提供されたコンテキストによって回答が完全にサポートされているという信頼度を評価するように促します。取得スコアのしきい値を使用します。取得されたチャンクの類似度スコアがしきい値を下回る場合、弱いコンテキストから回答を試みるのではなく、情報が不十分であることを示す応答を返します。そして、既知の回答を持つテスト質問全体でハルシネーション率を継続的に測定する評価パイプラインを構築します。
ドキュメントの変更に合わせて最新の状態を保つRAGシステムを構築できますか?+
はい。本番のRAGシステムには、ドキュメントの変更を検出し、それに応じてベクトルインデックスを更新する自動パイプラインが必要です。これは、デモRAGシステムと本番RAGシステムの重要な違いの1つです。アプローチはドキュメントソースによって異なります。Confluence、Notion、SharePoint、Google Driveなどのクラウドプラットフォームに保存されているドキュメントの場合、取り込みパイプラインはプラットフォームAPIを使用して、新しいページ、変更されたページ、削除されたページをスケジュールに基づいて検出します。通常、コンテンツの変更頻度に応じて、1時間ごとまたは毎日です。新しいページはチャンク化され、埋め込まれ、ベクトルインデックスに追加されます。変更されたページは古いチャンクが削除され、新しいチャンクが挿入されます。削除されたページはインデックスからチャンクが削除されます。ファイルベースのドキュメントストアの場合、パイプラインはチェックサムまたは変更タイムスタンプを使用して、ディレクトリのファイル変更を監視します。Webコンテンツの場合、パイプラインはスケジュールに基づいてソースURLを再クロールし、コンテンツハッシュを比較して変更を検出します。主要なアーキテクチャ上の決定事項は、同期頻度(パイプラインが変更をチェックする頻度)と変更検出の粒度(ドキュメント全体を再処理するか、変更されたセクションのみを再処理するか)です。変更されたコンテンツのみを再埋め込みする増分処理は、完全な再取り込みよりも効率的ですが、実装はより複雑です。また、メタデータの更新も処理する必要があります。ドキュメントのタイトル、作成者、カテゴリが変更された場合、ベクトルデータベース内の関連するチャンクメタデータを更新する必要があります。Zinn Hubのスペシャリストは、本番RAG展開の一部としてこれらの自動同期パイプラインを構築し、手動介入なしでナレッジベースを最新の状態に保ちます。
Zinn HubでRAGとナレッジベースのスペシャリストをどのように選びますか?+
Zinn HubでRAGおよびナレッジベースのスペシャリストを選ぶ際には、プロンプトエンジニアリングやチャットボットインターフェースだけでなく、エンドツーエンドのRAGシステム構築における実証された経験を探してください。RAGには、ドキュメント処理、埋め込みモデル、ベクトルデータベース、検索アルゴリズム、プロンプトエンジニアリング、評価など、複数の技術分野が関与しており、スペシャリストはそれらすべてにおいて深い知識を持っている必要があります。彼らのポートフォリオで、あなたのものと同様のドキュメントタイプとボリュームを扱うRAGプロジェクトを確認してください。テーブルや画像を含む複雑なPDFがある場合は、それらの特定の解析課題の経験があることを確認してください。Confluence、SharePoint、またはデータベースからの複数ソースの取り込みが必要な場合は、それらの特定の統合の経験を確認してください。購入者のレビューを読んで、回答の正確性、検索品質、システムの信頼性、ドキュメントに関するフィードバックを確認してください。チャンキングと埋め込みのアプローチについて尋ねてください。優れたスペシャリストは、チャンキング戦略間のトレードオフについて議論し、一律の方法を使用するのではなく、コンテンツタイプに基づいてアプローチを推奨します。品質をどのように測定するか尋ねてください。プロのRAGエンジニアは、既知の質問と期待される回答を含む評価セットを構築し、検索の正確性、回答の正確性、幻覚率を定量的に測定します。幻覚防止へのアプローチについて尋ねてください。根拠となる指示、引用生成、信頼度スコアリング、検証ステップなどです。継続的なメンテナンスのためにシステムに何が含まれているか尋ねてください。自動再インデックス、監視ダッシュボード、精度追跡、アラート設定などです。エンタープライズ展開の場合、アクセス制御、マルチテナンシー、監査ログ、コンプライアンス要件の経験を確認してください。注文する前にスペシャリストにメッセージを送り、ドキュメントソース、ボリューム、質問タイプ、精度要件について話し合ってください。