

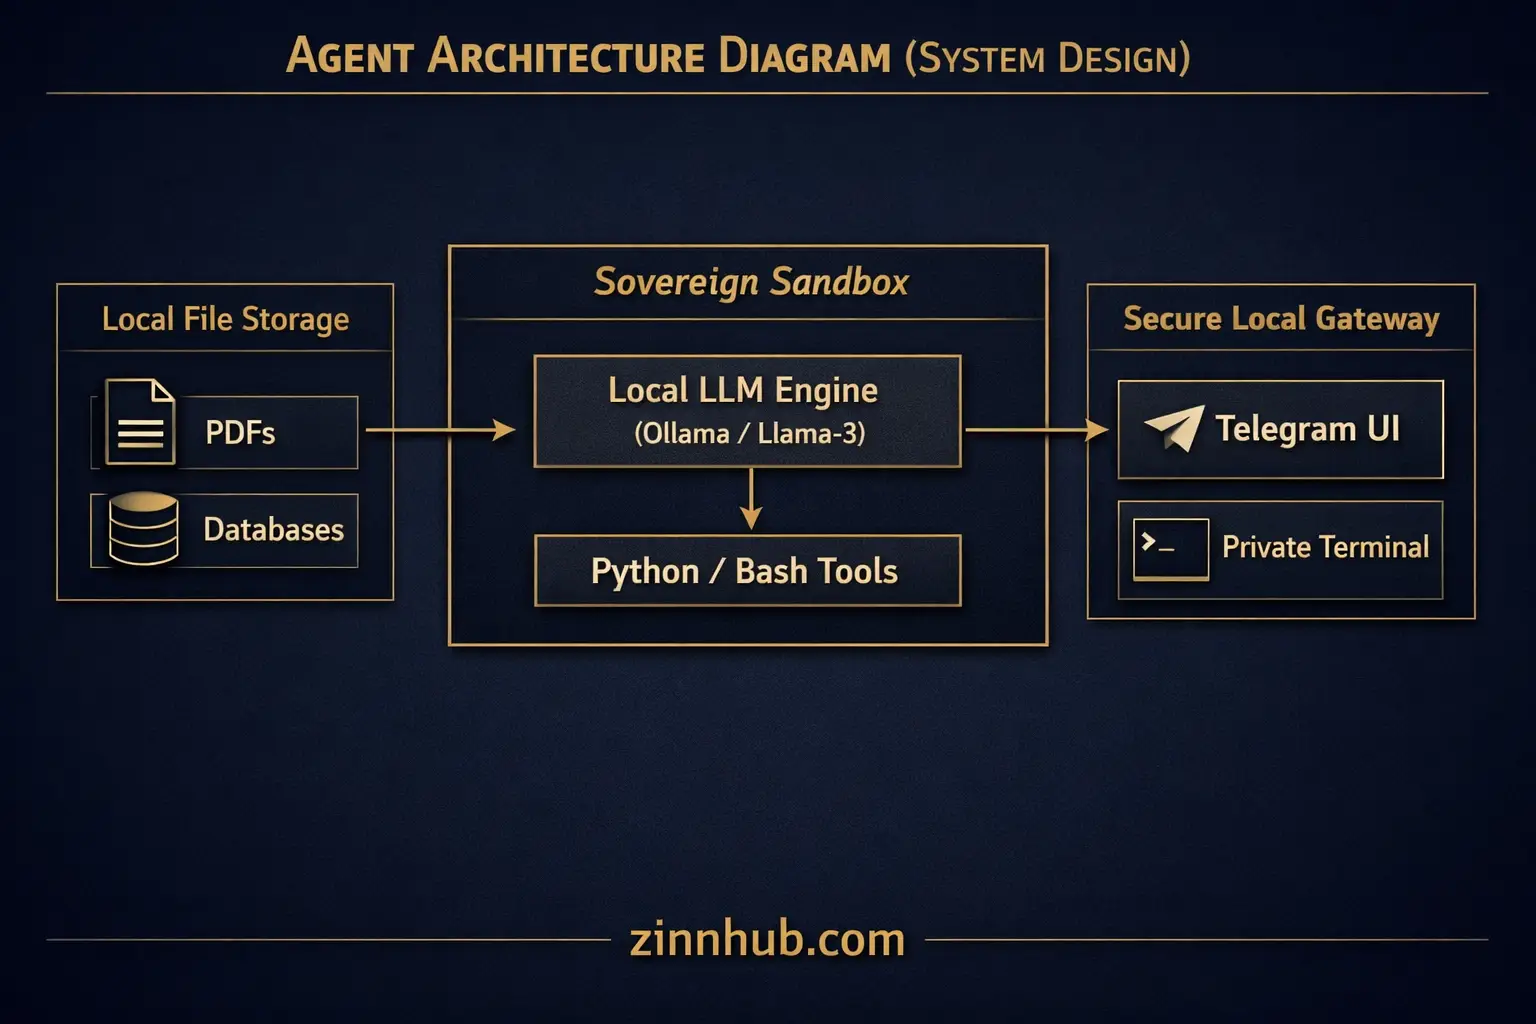
L'esecuzione di LLM locali e pipeline RAG richiede un preciso equilibrio di risorse hardware. Se i parametri del modello superano la VRAM della GPU o la RAM di sistema disponibili, la velocità di esecuzione scende a quasi zero poiché il sistema operativo è costretto a utilizzare l'archiviazione di sistema. Questo…
Condurrò un audit di compatibilità hardware e modello locale
Richiedi un'Offerta Personalizzata
Accedi per Richiedere un'Offerta Personalizzata
Crea un account gratuito o accedi per richiedere un'offerta personalizzata da questo Zinner.
Accedi / RegistratiFai una domanda pre-vendita
Accedi per fare una domanda
Per ridurre lo spam sulla piattaforma, i messaggi pre-vendita possono essere inviati solo da utenti registrati.
Crea un account gratuito o accedi per messaggiare direttamente questo Zinner.
Accedi / RegistratiAccesso richiesto
Crea un account gratuito o accedi per messaggiare questo Zinner.
Accedi / RegistratiAccesso richiesto
Crea un account gratuito o accedi per richiedere un'offerta personalizzata.
Accedi / RegistratiAt a Glance
Dettagli chiave su questo servizio per aiutarti a decidere. Generato da Zinn Hub, non dal venditore.
Posizione di Valore
Cosa ricevi
Consegna Rapida
Cosa devi fornire
Migliore per
Descrizione Completa
L'esecuzione di LLM locali e pipeline RAG richiede un preciso equilibrio di risorse hardware. Se i parametri del modello superano la VRAM della GPU o la RAM di sistema disponibili, la velocità di esecuzione scende a quasi zero poiché il sistema operativo è costretto a utilizzare l'archiviazione di sistema.
Questo Micro Zinn fornisce un audit di compatibilità completo del tuo hardware prima di acquistare o installare qualsiasi software. Valutiamo il tuo sistema fisico—che sia un Mac Apple Silicon, una workstation NVIDIA CUDA o un server Windows/Linux standard—per dirti esattamente come ottenere prestazioni locali ottimali.
Cosa analizziamo:
1. Vincoli VRAM GPU: Mappiamo la tua memoria grafica dedicata per trovare il tuo limite massimo di parametri del modello (ad esempio, modelli 7B, 13B o 34B).
2. Allocazione RAM di sistema: Determiniamo le tue soglie di inferenza CPU e i limiti di offloading se non disponi di una GPU dedicata o esegui su memoria di sistema condivisa.
3. Mappatura della quantizzazione: Raccomandiamo il livello di quantizzazione esatto (come Q4_K_M, Q5_K_M o Q8_0) per bilanciare velocità di elaborazione e intelligenza del modello.
4. Limiti della finestra di contesto: Calcoliamo i tuoi limiti massimi di token sicuri per prevenire crash del sistema per esaurimento della memoria durante il recupero di documenti pesanti.
Smetti di indovinare quali pesi open-source scaricare o perché la tua configurazione locale è lenta. Ottieni una mappa ingegnerizzata e specifica per l'hardware per il tuo ambiente AI locale da operatori che costruiscono questi sistemi su hardware fisico ogni giorno.
Audit di compatibilità hardware completato, mappando i limiti dei parametri del modello Ollama, le scale della finestra di contesto e le quantizzazioni ottimali Q4/Q5 per 128 GB di RAM.
Visualizza esempio ↗Un Micro Zinn è un piccolo assaggio o micro servizio a prezzo fisso. CAVOK_Designs offre questo per:
Vetrina delle competenzeCostruttore di portfolioAperto a nuovi clientiGaranzia di Qualità Zinner
Ogni Zinner è revisionato e approvato prima di aderire alla piattaforma.
Tutti i servizi sono supportati dal nostro impegno di garanzia della qualità.
Il tuo pagamento è protetto fino a quando non approvi il lavoro consegnato.
Recensioni dei clienti
Scopri cosa dicono i nostri clienti di questo Zinn

