Sewa Spesialis RAG & Basis Pengetahuan
Pengetahuan organisasi Anda terkunci di dalam dokumen, wiki, database, dan sistem file yang tidak dapat diakses oleh model AI secara default — dan satu-satunya cara untuk membangun sistem AI yang menjawab pertanyaan secara akurat dari data spesifik Anda adalah dengan generasi yang diperkaya pengambilan (retrieval augmented generation). RAG adalah arsitektur yang mengubah model AI tujuan umum menjadi ahli dalam bisnis Anda dengan menghubungkannya ke dokumen Anda pada saat kueri, memberikannya konteks yang dibutuhkan untuk memberikan jawaban yang beralasan, akurat, dan dapat dikutip alih-alih respons generik atau informasi yang dihalusinasi.
Di Zinn Hub, insinyur AI berpengalaman membangun pipeline RAG kustom, sistem basis data vektor, alur kerja penyerapan dokumen, chatbot basis pengetahuan, implementasi pencarian hibrida, dan kerangka kerja evaluasi yang membuat pengetahuan organisasi Anda dapat dicari melalui bahasa alami. Ini adalah spesialis yang memahami tumpukan RAG penuh — penguraian dokumen, strategi chunking, model embedding, basis data vektor, algoritma pengambilan, rekayasa prompt untuk generasi yang mendasar, dan metodologi evaluasi yang memisahkan sistem yang andal dari yang tidak dapat diandalkan. Bayar dengan kripto di setiap daftar dan $500 pertama Anda bebas komisi.
Mengapa RAG Penting untuk Bisnis Anda
Setiap organisasi memiliki masalah pengetahuan — informasi penting tersebar di seluruh dokumentasi, kebijakan, artikel bantuan, wiki internal, utas Slack, arsip email, dan keahlian individu. Karyawan menghabiskan waktu berjam-jam mencari jawaban yang ada di suatu tempat dalam organisasi tetapi sulit ditemukan. Pelanggan menunggu tanggapan dukungan sementara agen mencari basis pengetahuan secara manual. Anggota tim baru membutuhkan waktu berbulan-bulan untuk beradaptasi karena pengetahuan institusional tidak terdokumentasi atau terkubur. RAG menyelesaikannya dengan membuat lapisan AI di atas pengetahuan Anda yang ada yang dapat ditanyakan siapa pun dalam bahasa alami. Alih-alih mencari melalui lusinan dokumen dan berharap kata kunci yang tepat cocok, pengguna mengajukan pertanyaan secara alami dan menerima jawaban yang akurat dengan kutipan yang menunjuk ke dokumen sumber. AI tidak menebak — ia mengambil bagian yang relevan dari data Anda dan menghasilkan jawaban yang didasarkan pada bukti tersebut. Ini secara fundamental berbeda dari memberikan karyawan akses ke ChatGPT, yang tidak tahu apa-apa tentang bisnis spesifik Anda. Sistem RAG yang dilatih pada dokumentasi Anda menjadi ahli yang selalu tersedia tentang produk, proses, kebijakan, dan prosedur Anda — yang menjawab secara konsisten, tidak pernah lupa, dan dapat diskalakan untuk melayani setiap orang di organisasi Anda secara bersamaan.
Layanan RAG & Basis Pengetahuan di Zinn Hub
- Pengembangan Pipeline RAG Kustom — Sistem generasi augmented retrieval end-to-end yang menghubungkan dokumen Anda ke model AI. Penyerapan dokumen, pemotongan, penyematan, penyimpanan vektor, pengambilan, rekayasa prompt, dan pembuatan jawaban dengan dukungan kutipan.
- Pengaturan & Konfigurasi Basis Data Vektor — Instalasi Pinecone, Weaviate, Qdrant, Milvus, ChromaDB, atau pgvector, desain skema, strategi pengindeksan, pemfilteran metadata, konfigurasi namespace, dan optimisasi kinerja kueri.
- Pipa Penyerapan Dokumen — Pemrosesan otomatis PDF, dokumen Word, spreadsheet, halaman web, Confluence, Notion, SharePoint, Google Drive, dan sumber lain menjadi konten yang dipecah, disematkan, diindeks dengan deteksi perubahan dan pengindeksan ulang bertahap.
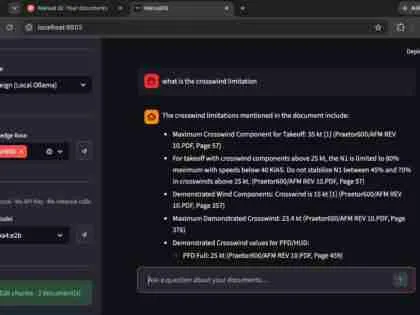
- Sistem Tanya Jawab Dokumen Bertenaga AI — Antarmuka obrolan atau pencarian di mana pengguna mengajukan pertanyaan bahasa alami dan menerima jawaban akurat yang bersumber dari dokumentasi Anda dengan kutipan, skor kepercayaan, dan tautan ke materi sumber.
- Chatbot Basis Pengetahuan — Asisten AI yang menghadap pelanggan atau internal yang menjawab pertanyaan dari basis pengetahuan, dokumen produk, pusat bantuan, SOP, atau dokumen kebijakan Anda dengan antarmuka bermerek, riwayat percakapan, dan pengumpulan umpan balik.
- Implementasi Pencarian Hibrida — Menggabungkan pencarian kemiripan vektor dengan pencarian kata kunci BM25 untuk pengambilan yang menangani makna semantik dan terminologi yang tepat, jargon teknis, dan kata benda yang mungkin terlewatkan oleh pencarian vektor murni.
- Optimasi Strategi Chunking — Pengujian sistematis pendekatan chunking ukuran tetap, semantik, rekursif, dan induk-anak terhadap jenis konten Anda dengan perbandingan akurasi terkuantifikasi untuk menentukan strategi optimal.
- Pemilihan & Penyesuaian Model Embedding — Membandingkan OpenAI, Cohere, Voyage, BGE, E5, dan model embedding lainnya dengan data Anda. Penyesuaian opsional pada kosakata domain Anda untuk relevansi pengambilan yang lebih baik.
- Sistem RAG Multi-Modal — Pengambilan data melalui gambar, diagram, bagan, dan tabel selain teks, memungkinkan AI untuk menjawab pertanyaan tentang konten visual yang tertanam dalam dokumen Anda.
- Evaluasi & Pemantauan RAG — Pipeline evaluasi otomatis yang mengukur akurasi pengambilan, kebenaran jawaban, tingkat halusinasi, dan kualitas respons. Dasbor pemantauan produksi dengan pelacakan akurasi, metrik latensi, dan analitik penggunaan.
Lapisan Arsitektur RAG
Sistem RAG produksi melibatkan beberapa lapisan teknis yang masing-masing memengaruhi kualitas jawaban. Lapisan penyerapan menangani penguraian, pembersihan, dan pemotongan dokumen. Lapisan penyematan mengubah potongan teks menjadi representasi vektor. Lapisan penyimpanan — basis data vektor — mengindeks dan menyajikan vektor ini untuk pencarian kesamaan yang cepat. Lapisan pengambilan menggabungkan strategi pencarian, menerapkan filter, dan memberi peringkat hasil. Lapisan generasi menggunakan rekayasa prompt untuk mendasarkan respons model AI pada konteks yang diambil. Dan lapisan evaluasi mengukur kualitas ujung ke ujung. Kelemahan pada lapisan mana pun menurunkan seluruh sistem, itulah sebabnya RAG membutuhkan spesialis yang memahami tumpukan penuh, bukan hanya satu komponen.
Layanan Terkait
Pengembangan RAG dan basis pengetahuan terhubung dengan layanan AI dan pengembangan lainnya di Zinn Hub. Untuk prompt yang menggerakkan lapisan generasi sistem RAG Anda, jelajahi layanan rekayasa prompt. Untuk alur kerja otomatis yang memicu kueri RAG dan memproses hasilnya, lihat layanan otomatisasi dan alur kerja AI. Untuk membangun antarmuka bertenaga RAG tanpa kode, jelajahi pengembangan tanpa kode dan kode rendah. Untuk pelatihan dan penyetelan model AI kustom yang melengkapi RAG, jelajahi kategori induk pengembangan AI. Untuk infrastruktur server yang menampung database vektor yang dikelola sendiri dan pipeline RAG, lihat administrasi server Linux. Untuk pipeline deployment dan infrastruktur-sebagai-kode untuk sistem RAG, jelajahi layanan rekayasa DevOps.
Apakah Anda seorang insinyur RAG yang berpengalaman? Mulai jual layanan RAG dan basis pengetahuan di Zinn Hub dan terhubung dengan bisnis di seluruh dunia yang membutuhkan sistem augmented generation retrieval kustom, keahlian database vektor, dan pencarian dokumen bertenaga AI. Daftar sebagai Zinner secara gratis dan mulai daftar hari ini.
Cara Mempekerjakan Spesialis RAG & Basis Pengetahuan
Tentukan Sumber Data dan Kasus Penggunaan Anda Identifikasi dokumen dan data yang perlu dicari oleh sistem AI Anda — PDF, artikel bantuan, wiki, database, halaman web, atau dokumentasi internal. Tentukan bagaimana pengguna akan berinteraksi dengan sistem dan tentukan persyaratan akurasi serta jenis pertanyaan yang diharapkan.
Pilih Spesialis RAG Jelajahi layanan RAG dan basis pengetahuan di Zinn Hub. Tinjau portofolio untuk pengalaman dengan jenis dokumen, volume data, dan lingkungan penerapan Anda. Periksa ulasan pembeli untuk akurasi jawaban dan keandalan sistem. Kirim pesan kepada spesialis untuk mendiskusikan kebutuhan Anda.
Sediakan Dokumen dan Akses Bagikan koleksi dokumen Anda atau berikan akses API ke platform konten Anda. Berikan contoh pertanyaan, jawaban yang diharapkan untuk evaluasi, dan terminologi khusus domain apa pun. Tentukan persyaratan kontrol akses jika pengguna yang berbeda harus melihat konten yang berbeda.
Evaluasi, Terapkan, dan Pantau Tinjau hasil evaluasi yang menunjukkan akurasi pengambilan, kebenaran jawaban, dan tingkat halusinasi. Uji dengan pengguna nyata dan kasus ekstrem. Terapkan dengan dasbor pemantauan yang melacak akurasi, penggunaan, dan kinerja. Terima dokumentasi arsitektur lengkap dan prosedur pemeliharaan.
Pertanyaan yang Sering Diajukan Tentang RAG & Basis Pengetahuan
Layanan RAG dan basis pengetahuan apa yang bisa saya beli di Zinn Hub?+
Zinn Hub menawarkan berbagai layanan pengembangan RAG dan basis pengetahuan dari insinyur AI berpengalaman. Anda dapat membeli pengembangan pipeline RAG kustom — sistem generasi augmented retrieval ujung-ke-ujung yang menghubungkan dokumen, database, dan sumber pengetahuan Anda ke model AI sehingga mereka menjawab pertanyaan secara akurat menggunakan data spesifik Anda. Pengaturan dan konfigurasi database vektor — instalasi Pinecone, Weaviate, Qdrant, Milvus, ChromaDB, atau pgvector, desain skema, strategi pengindeksan, pemfilteran metadata, dan optimasi kueri. Pipeline penyerapan dokumen — memproses PDF, dokumen Word, spreadsheet, halaman web, wiki Confluence, database Notion, pustaka SharePoint, dan sumber lain menjadi konten yang dipecah, disematkan, diindeks, siap untuk diambil. Sistem Tanya Jawab dokumen bertenaga AI — antarmuka chatbot atau pencarian di mana pengguna mengajukan pertanyaan bahasa alami dan menerima jawaban akurat yang bersumber langsung dari dokumentasi Anda dengan kutipan. Chatbot basis pengetahuan — asisten AI yang menghadap pelanggan atau internal yang menjawab pertanyaan dari basis pengetahuan Anda, dokumentasi produk, artikel pusat bantuan, SOP, atau dokumen kebijakan. Implementasi pencarian hibrida — menggabungkan pencarian kesamaan vektor dengan pencarian kata kunci tradisional menggunakan BM25 untuk pengambilan yang menangani makna semantik dan terminologi yang tepat. Optimasi strategi chunking — menguji dan menerapkan pendekatan pemisahan dokumen yang tepat untuk jenis konten Anda, menyeimbangkan ukuran chunk, tumpang tindih, dan pelestarian metadata untuk akurasi pengambilan yang optimal. Pemilihan dan penyetelan model embedding — memilih model embedding yang tepat untuk domain dan jenis konten Anda, membandingkan alternatif, dan secara opsional menyetel embedding pada data Anda untuk relevansi pengambilan yang lebih baik. Sistem RAG multi-modal — pengambilan atas gambar, diagram, tabel, dan bagan selain teks, memungkinkan AI untuk menjawab pertanyaan tentang konten visual dalam dokumen Anda. Dan evaluasi dan pemantauan RAG — membangun pipeline evaluasi yang mengukur akurasi pengambilan, kebenaran jawaban, tingkat halusinasi, dan kualitas respons dengan penilaian otomatis.
Berapa biaya layanan RAG dan basis pengetahuan di Zinn Hub?+
Biaya tergantung pada kompleksitas arsitektur RAG, volume dan keragaman dokumen sumber, serta tingkat akurasi yang dibutuhkan. Sistem RAG dasar yang menyerap satu koleksi dokumen hingga 500 halaman dengan antarmuka obrolan sederhana berharga $500-1500. Saluran RAG produksi dengan beberapa sumber dokumen, pencarian hibrida, pemfilteran metadata, pembuatan kutipan, dan UI obrolan yang disempurnakan berharga $1500-5000. Pengaturan dan konfigurasi basis data vektor dengan desain skema, optimasi pengindeksan, dan penyetelan kueri berharga $300-1000. Saluran penyerapan dokumen yang memproses konten dari Confluence, Notion, SharePoint, atau platform lain dengan sinkronisasi otomatis berharga $500-2000. Chatbot basis pengetahuan yang menghadap pelanggan dengan antarmuka bermerek, riwayat percakapan, pengumpulan umpan balik, dan analitik berharga $1000-4000. Implementasi pencarian hibrida yang menggabungkan pencarian vektor dan kata kunci dengan penyetelan relevansi berharga $500-1500. Optimasi strategi pemotongan dengan pengujian sistematis di berbagai pendekatan dan perbandingan akurasi terkuantifikasi berharga $300-1000. Pembandingan dan pemilihan model penyematan untuk domain konten spesifik Anda berharga $300-800. Sistem RAG perusahaan komprehensif dengan beberapa sumber data, kontrol akses berbasis peran, pencatatan audit, saluran evaluasi, dan pemantauan berkelanjutan berharga $3000-10000. Pemeliharaan bulanan berkelanjutan termasuk pengindeksan ulang, pemantauan akurasi, pembaruan prompt, dan sinkronisasi sumber biasanya berkisar antara $200-800 per bulan.
Apa itu RAG dan bagaimana cara kerjanya?+
RAG — Retrieval Augmented Generation — adalah arsitektur yang menghubungkan model bahasa AI ke data spesifik Anda sehingga mereka dapat menjawab pertanyaan secara akurat menggunakan informasi dari dokumen, database, dan sumber pengetahuan Anda daripada hanya mengandalkan data pelatihan mereka. Tanpa RAG, model AI hanya dapat merespons berdasarkan apa yang mereka pelajari selama pelatihan — mereka tidak dapat mengakses dokumentasi internal, spesifikasi produk, kebijakan perusahaan, data pelanggan, atau informasi apa pun yang tidak ada dalam set pelatihan mereka. RAG memecahkan masalah ini dengan menambahkan langkah pengambilan sebelum pembuatan. Proses ini bekerja dalam tiga tahap. Pertama, dokumen Anda diproses selama fase penyerapan — dokumen tersebut dibagi menjadi beberapa bagian, setiap bagian diubah menjadi representasi numerik yang disebut embedding menggunakan model embedding, dan embedding ini disimpan dalam database vektor bersama dengan teks asli dan metadata. Kedua, ketika pengguna mengajukan pertanyaan, pertanyaan tersebut juga diubah menjadi embedding dan database vektor dicari untuk bagian-bagian yang embedding-nya paling mirip dengan embedding pertanyaan — ini adalah pencarian semantik, menemukan konten berdasarkan makna daripada pencocokan kata kunci. Ketiga, bagian-bagian yang paling relevan diambil dan diteruskan ke model AI sebagai konteks di samping pertanyaan pengguna, dan model menghasilkan jawaban yang didasarkan pada konten yang diambil tersebut. Hasilnya adalah sistem AI yang menjawab pertanyaan secara akurat menggunakan data spesifik Anda, dapat mengutip sumbernya, tetap terkini saat dokumen Anda diperbarui, dan tidak mengarang informasi karena menghasilkan dari bukti yang diambil daripada memori.
Apa itu database vektor dan mengapa saya membutuhkannya untuk RAG?+
Basis data vektor adalah basis data khusus yang dirancang untuk menyimpan dan mencari vektor numerik berdimensi tinggi — representasi matematis dari teks, gambar, atau konten lain yang dibuat oleh model penyematan. Basis data tradisional mencari berdasarkan kecocokan persis atau pola kata kunci. Basis data vektor mencari berdasarkan kesamaan — dengan vektor kueri, mereka menemukan vektor tersimpan yang paling dekat maknanya, meskipun menggunakan kata-kata yang sama sekali berbeda. Anda memerlukan basis data vektor untuk RAG karena pencarian semantik adalah mekanisme inti yang membuat pengambilan berfungsi. Ketika pengguna mengajukan pertanyaan tentang dokumentasi Anda, sistem perlu menemukan bagian yang paling relevan — bukan dengan mencocokkan kata kunci, tetapi dengan memahami makna. Pertanyaan tentang kebijakan pengembalian perlu menemukan dokumentasi pengembalian Anda meskipun kata "pengembalian" yang tepat tidak muncul dalam kueri. Basis data vektor membuat pencarian kesamaan ini cepat dan terukur, bahkan di jutaan potongan dokumen. Basis data vektor populer termasuk Pinecone yang merupakan layanan cloud yang dikelola sepenuhnya dengan akses API sederhana dan penskalaan otomatis. Weaviate yang merupakan sumber terbuka dengan pencarian hibrida bawaan yang menggabungkan pengambilan vektor dan kata kunci. Qdrant yang merupakan sumber terbuka dengan kemampuan pemfilteran yang kuat dan penggunaan memori yang efisien. ChromaDB yang ringan dan ramah pengembang, ideal untuk pembuatan prototipe dan penerapan yang lebih kecil. Milvus yang merupakan sumber terbuka dan dirancang untuk penerapan perusahaan skala besar. Dan pgvector yang merupakan ekstensi PostgreSQL yang menambahkan pencarian vektor ke basis data PostgreSQL Anda yang sudah ada, menghindari kebutuhan akan sistem terpisah. Pilihan tergantung pada skala, preferensi infrastruktur, apakah Anda ingin dikelola atau di-host sendiri, dan apakah Anda memerlukan fitur seperti pencarian hibrida, multi-tenancy, atau pemfilteran lanjutan.
Apa perbedaan antara RAG dan fine-tuning model AI?+
RAG dan fine-tuning memecahkan masalah yang berbeda dan seringkali membingungkan. Fine-tuning memodifikasi model AI itu sendiri dengan melatihnya pada data tambahan — model secara permanen mempelajari pola baru, gaya penulisan, atau pengetahuan domain. RAG tidak memodifikasi model — ia menyediakan konteks yang relevan pada waktu kueri dari basis pengetahuan eksternal, dan model menghasilkan jawaban yang didasarkan pada konteks tersebut. Fine-tuning paling baik untuk mengajarkan model gaya penulisan, nada, atau format tertentu. Untuk menyematkan terminologi khusus domain dan pola penalaran ke dalam model. Untuk mengurangi panjang prompt dengan mengkodekan instruksi umum ke dalam bobot model. Dan untuk tugas-tugas di mana pengetahuan yang dibutuhkan stabil dan tidak sering berubah. RAG paling baik untuk menjawab pertanyaan dari koleksi dokumen yang besar dan berkembang. Untuk tugas-tugas di mana informasi sumber sering berubah dan perlu tetap terkini. Untuk memberikan jawaban yang dikutip, dapat diverifikasi yang dapat dilacak ke dokumen sumber tertentu. Untuk bekerja dengan data kepemilikan atau sensitif yang tidak boleh disertakan dalam pelatihan model. Dan untuk tugas-tujuan di mana akurasi dan kejelasan lebih penting daripada adaptasi gaya. Dalam praktiknya, RAG adalah pilihan yang tepat untuk sebagian besar basis pengetahuan bisnis dan aplikasi Tanya Jawab dokumen karena informasi berubah seiring waktu, pengguna perlu memverifikasi jawaban terhadap sumber, dan volume konten terlalu besar untuk disesuaikan ke dalam model secara ekonomis. Kedua pendekatan dapat digabungkan — model yang disesuaikan yang juga menggunakan RAG untuk pengambilan — tetapi sebagian besar implementasi dimulai dengan RAG saja karena memberikan nilai langsung tanpa biaya dan kompleksitas pelatihan model.
Bagaimana cara menangani berbagai jenis dokumen dalam sistem RAG?+
Basis pengetahuan dunia nyata berisi beragam jenis dokumen yang masing-masing memerlukan pendekatan penyerapan yang berbeda. PDF adalah yang paling umum dan paling menantang — dapat berisi teks, tabel, gambar, header, footer, tata letak multi-kolom, dan halaman yang dipindai. PDF berbasis teks diurai dengan pustaka seperti PyMuPDF, pdfplumber, atau Unstructured, dengan penanganan khusus yang diperlukan untuk tabel dan tata letak multi-kolom. PDF yang dipindai memerlukan OCR dengan alat seperti Tesseract atau layanan OCR cloud sebelum teks dapat dipecah dan disematkan. Dokumen Word diurai dengan python-docx atau pustaka serupa, mempertahankan struktur judul untuk pemecahan cerdas yang menghormati hierarki dokumen. Spreadsheet memerlukan konversi baris atau bagian menjadi deskripsi bahasa alami atau representasi teks terstruktur yang dapat diproses secara bermakna oleh model penyematan. Halaman web dikeruk dan dibersihkan untuk mengekstrak konten utama sambil menghapus navigasi, iklan, dan boilerplate. Konten Confluence, Notion, dan SharePoint diakses melalui API masing-masing, dengan struktur halaman dan metadata dipertahankan. Repositori kode memerlukan pemecahan khusus yang menghormati batas fungsi dan kelas. File Markdown dan teks biasa adalah yang paling sederhana untuk diproses tetapi masih mendapat manfaat dari pemecahan yang sadar struktur. Prinsip utamanya adalah bahwa setiap jenis dokumen membutuhkan strategi penguraian dan pemecahan yang disesuaikan — pipeline yang berfungsi baik untuk dokumen teks bersih akan menghasilkan hasil yang buruk pada PDF kompleks dengan tabel dan diagram. Sistem RAG yang kuat mencakup deteksi jenis dokumen, parser khusus untuk setiap jenis, dan pemeriksaan kualitas yang menandai kegagalan penguraian sebelum konten yang rusak masuk ke indeks.
Apa itu chunking dan mengapa ukuran chunk penting?+
Chunking adalah proses membagi dokumen Anda menjadi bagian-bagian yang lebih kecil yang masing-masing disematkan dan disimpan dalam database vektor. Ketika pengguna mengajukan pertanyaan, sistem mengambil bagian yang paling relevan — bukan seluruh dokumen — sehingga ukuran chunk secara langsung memengaruhi akurasi pengambilan dan kualitas jawaban. Jika chunk terlalu besar, chunk tersebut mengandung terlalu banyak informasi dan kalimat yang relevan diencerkan oleh konten di sekitarnya. Embedding mewakili makna rata-rata dari seluruh chunk, sehingga chunk besar tentang beberapa topik tidak akan cocok dengan pertanyaan spesifik tentang salah satu topik tersebut. Chunk besar yang diambil juga mengonsumsi lebih banyak jendela konteks model AI, menyisakan lebih sedikit ruang untuk beberapa sumber dan prompt generasi. Jika chunk terlalu kecil, chunk tersebut kehilangan konteks — satu kalimat mungkin tidak mengandung cukup informasi bagi model untuk menghasilkan jawaban yang berguna, dan konteks penting dari kalimat di sekitarnya hilang. Chunk yang sangat kecil juga meningkatkan jumlah vektor dalam database dan jumlah hasil pengambilan yang diperlukan untuk mencakup suatu topik. Ukuran chunk yang optimal bergantung pada jenis konten dan pola pertanyaan Anda. Untuk dokumentasi faktual seperti artikel bantuan dan panduan produk, chunk 200-500 token berfungsi dengan baik karena informasi cenderung terkonsentrasi. Untuk konten naratif seperti laporan dan analisis, chunk yang lebih besar yaitu 500-1000 token mempertahankan alur penalaran. Tumpang tindih antar chunk — biasanya 50-100 token konten bersama di batas chunk — memastikan bahwa informasi yang terbagi di batas chunk masih dapat diambil. Pendekatan yang lebih canggih termasuk chunking semantik yang membagi pada batas topik alami, chunking rekursif yang menciptakan representasi hierarkis, dan chunking induk-anak di mana chunk kecil diambil tetapi chunk induk yang lebih besar diteruskan ke model untuk konteks yang lebih banyak.
Bagaimana cara mengurangi halusinasi dalam sistem RAG?+
Halusinasi dalam sistem RAG terjadi ketika model AI menghasilkan informasi yang tidak ada dalam konteks yang diambil — baik mengarang fakta, salah merepresentasikan konten sumber, atau memadukan informasi yang diambil dengan pengetahuan pelatihannya sendiri dengan cara yang menyesatkan. Beberapa teknik mengurangi halusinasi secara sistematis. Tingkatkan akurasi pengambilan terlebih dahulu — penyebab paling umum halusinasi bukanlah model tetapi pengambilan yang buruk. Jika dokumen sumber yang benar tidak diambil, model akan mengakui bahwa ia tidak dapat menjawab, yang merupakan perilaku yang diinginkan, atau menghasilkan jawaban dari data pelatihannya, yang merupakan halusinasi. Chunking yang lebih baik, pencarian hibrida, pemfilteran metadata, dan pemilihan model embedding semuanya meningkatkan akurasi pengambilan. Gunakan instruksi grounding eksplisit dalam prompt sistem Anda — instruksikan model untuk menjawab hanya dari konteks yang diberikan, untuk mengatakan tidak tahu ketika konteks tidak berisi jawaban, dan untuk tidak pernah melengkapi dengan informasi dari data pelatihannya. Sertakan persyaratan kutipan — instruksikan model untuk mengutip sumber dan bagian spesifik untuk setiap klaim, yang memaksanya untuk mendasarkan setiap pernyataan pada konten yang diambil dan membuat klaim yang dibuat-buat menjadi jelas. Terapkan verifikasi jawaban — gunakan panggilan AI kedua untuk memeriksa apakah jawaban yang dihasilkan benar-benar didukung oleh konteks yang diambil, menandai atau memfilter respons di mana klaim tidak dapat dilacak ke materi sumber. Tambahkan penilaian kepercayaan diri — minta model untuk menilai kepercayaannya bahwa jawaban sepenuhnya didukung oleh konteks yang diberikan. Gunakan ambang batas skor pengambilan — jika skor kesamaan chunk yang diambil di bawah ambang batas, kembalikan respons yang menunjukkan informasi yang tidak memadai daripada mencoba jawaban dari konteks yang lemah. Dan bangun pipeline evaluasi yang terus-menerus mengukur tingkat halusinasi di seluruh pertanyaan tes dengan jawaban yang diketahui.
Bisakah saya membangun sistem RAG yang tetap mutakhir seiring perubahan dokumen saya?+
Ya — sistem RAG produksi membutuhkan pipeline otomatis yang mendeteksi perubahan dokumen dan memperbarui indeks vektor sesuai dengan itu. Ini adalah salah satu perbedaan penting antara sistem RAG demo dan sistem produksi. Pendekatannya tergantung pada sumber dokumen Anda. Untuk dokumen yang disimpan di platform cloud seperti Confluence, Notion, SharePoint, atau Google Drive, pipeline penyerapan menggunakan API platform untuk mendeteksi halaman baru, yang dimodifikasi, dan yang dihapus sesuai jadwal — biasanya setiap jam atau setiap hari tergantung seberapa sering konten Anda berubah. Halaman baru dipecah, di-embed, dan ditambahkan ke indeks vektor. Halaman yang dimodifikasi akan dihapus bagian lamanya dan disisipkan bagian barunya. Halaman yang dihapus akan dihapus bagiannya dari indeks. Untuk penyimpanan dokumen berbasis file, pipeline memantau direktori untuk perubahan file menggunakan checksum atau stempel waktu modifikasi. Untuk konten web, pipeline akan merayapi ulang URL sumber sesuai jadwal dan membandingkan hash konten untuk mendeteksi perubahan. Keputusan arsitektur utama adalah frekuensi sinkronisasi — seberapa sering pipeline memeriksa perubahan — dan granularitas deteksi perubahan — apakah Anda memproses ulang seluruh dokumen atau hanya bagian yang berubah. Pemrosesan inkremental yang hanya meng-embed ulang konten yang berubah lebih efisien tetapi lebih kompleks untuk diimplementasikan daripada penyerapan ulang penuh. Anda juga perlu menangani pembaruan metadata — ketika judul dokumen, penulis, atau kategori berubah, metadata bagian terkait dalam database vektor perlu diperbarui. Spesialis di Zinn Hub membangun pipeline sinkronisasi otomatis ini sebagai bagian dari penerapan RAG produksi sehingga basis pengetahuan Anda tetap terkini tanpa intervensi manual.
Bagaimana cara memilih spesialis RAG dan basis pengetahuan di Zinn Hub?+
Saat memilih spesialis RAG dan basis pengetahuan di Zinn Hub, carilah pengalaman yang terbukti dalam membangun sistem RAG ujung ke ujung — bukan hanya rekayasa prompt atau antarmuka chatbot. RAG melibatkan beberapa domain teknis termasuk pemrosesan dokumen, model embedding, database vektor, algoritma pengambilan, rekayasa prompt, dan evaluasi, dan spesialis tersebut membutuhkan kedalaman di semua domain tersebut. Tinjau portofolio mereka untuk proyek RAG yang menangani jenis dan volume dokumen yang serupa dengan Anda. Jika Anda memiliki PDF kompleks dengan tabel dan gambar, konfirmasikan bahwa mereka memiliki pengalaman dengan tantangan parsing spesifik tersebut. Jika Anda memerlukan penyerapan multi-sumber dari Confluence, SharePoint, atau database, periksa pengalaman dengan integrasi spesifik tersebut. Baca ulasan pembeli untuk umpan balik tentang akurasi jawaban, kualitas pengambilan, keandalan sistem, dan dokumentasi. Tanyakan tentang pendekatan chunking dan embedding mereka — spesialis yang baik akan membahas trade-off antara strategi chunking dan merekomendasikan pendekatan berdasarkan jenis konten Anda daripada menggunakan metode yang cocok untuk semua. Tanyakan bagaimana mereka mengukur kualitas — insinyur RAG profesional membangun set evaluasi dengan pertanyaan yang diketahui dan jawaban yang diharapkan serta mengukur akurasi pengambilan, kebenaran jawaban, dan tingkat halusinasi secara kuantitatif. Tanyakan tentang pendekatan mereka untuk pencegahan halusinasi — instruksi dasar, pembuatan kutipan, penilaian kepercayaan diri, dan langkah-langkah verifikasi. Tanyakan apa yang termasuk dalam sistem mereka untuk pemeliharaan berkelanjutan — pengindeksan ulang otomatis, dasbor pemantauan, pelacakan akurasi, dan konfigurasi peringatan. Untuk penerapan perusahaan, konfirmasikan pengalaman dengan kontrol akses, multi-tenancy, pencatatan audit, dan persyaratan kepatuhan. Kirim pesan kepada spesialis sebelum memesan untuk membahas sumber dokumen Anda, volume, jenis pertanyaan, dan persyaratan akurasi.