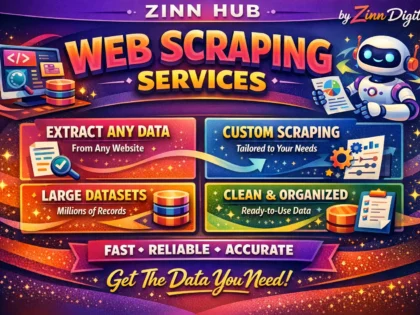
Aangepaste webscrapers in Python of Node.js — enkele sites, crawls van meerdere pagina's, JS-intensieve pagina's, anti-bot-afhandeling en schone CSV/JSON/DB-uitvoer. Geleverd in 2–10 dagen.

Ik bouw een Python- of Node.js-webscraper met anti-botafhandeling en schone CSV- of JSON-uitvoer
Scraper voor één site, één pagina met schone CSV- of JSON-uitvoer.
- Volledige broncode + installatie
- Eén doel-URL gescrapet
- Tot 10 velden per item geëxtraheerd
- Statische HTML-parsing (geen JS-rendering)
- CSV- of JSON-uitvoer
- Deduplicatie + veldnormalisatie
- Basis foutafhandeling en logboekregistratie
- README
Crawl van meerdere pagina's met paginering, JS-rendering en anti-bot-afhandeling.
- Volledige broncode + installatie
- Eén doel-URL gescrapet
- Statische HTML-parsing (geen JS-rendering)
- Deduplicatie + veldnormalisatie
- Basis foutafhandeling en logboekregistratie
- README
- Gestructureerd foutenlogboek + wachtrij voor opnieuw proberen
- Crawl van meerdere pagina's met pagineringsondersteuning
- JavaScript-gerenderde pagina's (Puppeteer of Playwright)
- Anti-bot-afhandeling — UA-rotatie, headers, verzoekbeperking
- Ondersteuning voor proxyrotatie
- Naleving van snelheidslimiet met backoff bij 429/503
- Tot 25 velden per item
- Onbeperkt aantal records
- Uitvoer naar CSV, JSON of Google Sheets
Volledige datapijplijn met planning, database-uitvoer, monitoring en dashboard.
- Volledige broncode + installatie
- Eén doel-URL gescrapet
- Statische HTML-parsing (geen JS-rendering)
- Deduplicatie + veldnormalisatie
- Basis foutafhandeling en logboekregistratie
- README
- Gestructureerd foutenlogboek + wachtrij voor opnieuw proberen
- Crawl van meerdere pagina's met pagineringsondersteuning
- JavaScript-gerenderde pagina's (Puppeteer of Playwright)
- Anti-bot-afhandeling — UA-rotatie, headers, verzoekbeperking
- Ondersteuning voor proxyrotatie
- Naleving van snelheidslimiet met backoff bij 429/503
- Tot 25 velden per item
- Onbeperkt aantal records
- Uitvoer naar CSV, JSON of Google Sheets
- Prioritaire leveringsslot
- Onbeperkt aantal velden + aangepaste schematoewijzing
- Database-uitvoer — PostgreSQL, MySQL, MongoDB of SQLite
- Geplande uitvoeringen — cron, GitHub Actions, AWS Lambda of Vercel
- Cron Wijzigingsdetectie tussen uitvoeringen (nieuwe / bijgewerkte / verwijderde records)
- Ondersteuning voor content met inlogpoort (sessiebeheer, formulierinzending)
- CAPTCHA-bewuste flow (handmatige oplossingsintegratie of externe oplosser)
- Docker-gebaseerde implementatie
- Monitoringdashboard of Slack-/e-mailwaarschuwingen bij storing
- Loom-walkthrough van de volledige pijplijn
- 30 dagen ondersteuning na levering
Vraag een offerte op maat aan
Inloggen om een aangepaste aanbieding aan te vragen
Maak een gratis account aan of log in om een gepersonaliseerde aanbieding van deze Zinner aan te vragen.
Inloggen / RegistrerenStel een vraag vóór de verkoop
Inloggen om een vraag te stellen
Om platformspam te verminderen, kunnen pre-sale berichten alleen worden verzonden door ingelogde gebruikers.
Maak een gratis account aan of log in om deze Zinner direct een bericht te sturen.
Inloggen / RegistrerenInloggen vereist
Maak een gratis account aan of log in om deze Zinner een bericht te sturen.
Inloggen / RegistrerenInloggen vereist
Maak een gratis account aan of log in om een gepersonaliseerde aanbieding aan te vragen.
Inloggen / RegistrerenIn één oogopslag
Belangrijke details over deze service om u te helpen een beslissing te nemen. Gegenereerd door Zinn Hub, niet door de verkoper.
Waardepositie
Tech Stack
Anti-Bot Handling
Uitvoerformaten
Planning & Monitoring
Wat u ontvangt
Volledige beschrijving
SCRAPEHUB — Webscrapers die de gegevens daadwerkelijk ophalen
Productieklare webscrapers gebouwd in Python of Node.js — ontworpen om echte sites te verwerken, niet alleen nette HTML-demo's. Of het doel nu een productcatalogus, een directory, een marktplaats of een JS-intensieve single-page-app is, SCRAPEHUB levert schone gestructureerde gegevens in CSV, JSON of rechtstreeks aan uw database.
Wat er wordt gebouwd:
· Extractie van één pagina — gestructureerde gegevens van één URL halen met velden die zijn toegewezen aan uw specificatie
· Crawls van meerdere pagina's — paginering, categorietraversal, sitemap-gestuurde ontdekking
· JavaScript-gerenderde pagina's — Puppeteer, Playwright of Selenium voor SPA's en dynamische inhoud
· Inlog-beveiligde inhoud — sessiebeheer, cookiebeheer, formulierinzending
· Anti-bot-afhandeling — roterende user agents, proxyrotatie, verzoekbeperking, header-spoofing
· CAPTCHA-bewuste stromen — handmatige oplossingsintegratie waar nodig, of API's van derden voor oplossers
· Naleving van snelheidsbeperking — respect voor crawl-vertraging, terugval bij 429/503, afstemming van gelijktijdigheid
· Gegevensopschoning — deduplicatie, normalisatie, veldtoewijzing, datum- en prijsanalyse
· Uitvoerformaten — CSV, JSON, Excel, Google Sheets, PostgreSQL, MySQL, MongoDB, Airtable
· Geplande uitvoeringen — cron-taken, GitHub Actions of cloudfuncties voor terugkerende scrapes
· Wijzigingsdetectie — markeer nieuwe, bijgewerkte of verwijderde records tussen uitvoeringen
· Foutregistratie — gestructureerde logboeken, herhaalpogingwachtrijen, afhandeling van dode letters
Wat SCRAPEHUB anders maakt:
De meeste scrapers werken in een demo en breken zodra een site zijn DOM bijwerkt, een user agent blokkeert of Cloudflare toevoegt. SCRAPEHUB bouwt voor de rommelige echte wereld — veerkrachtige selectors, herhaallogica, proxy-fallback, gestructureerde logging en duidelijke storingsmodi, zodat u altijd weet wat er is gebeurd.
Sites breken zelden netjes. Een selector verandert, een veld verdwijnt, een pagina retourneert 403 in plaats van gegevens. SCRAPEHUB behandelt die gevallen expliciet — logt welke records zijn mislukt en waarom, in plaats van stilzwijgend lege rijen terug te geven.
Gebruikte tech-stack:
· Talen: Python (BeautifulSoup, Scrapy, Playwright, Selenium, Requests), Node.js (Puppeteer, Cheerio, Playwright, Axios)
· Anti-bot: roterende proxy's, User-Agent-rotatie, headless browser fingerprinting
· Opslag: CSV, JSON, Excel, Google Sheets, PostgreSQL, MySQL, MongoDB, SQLite, Airtable
· Planning: cron, GitHub Actions, AWS Lambda, Vercel Cron, Railway
· Infrastructuur: Docker, VPS (Hetzner, DigitalOcean), AWS, Render
Test- & QA-dekking:
Elke scraper wordt geleverd met een proefdraai op een kleine steekproef, daarna een volledige draai met een succes-/foutoverzicht. De uitvoer wordt gevalideerd aan de hand van het verwachte schema — ontbrekende velden, dubbele rijen en parseerfouten worden gemarkeerd vóór levering.
Eigendom & NDA:
Volledige broncode en scraper-referenties worden bij de uiteindelijke levering overgedragen aan de koper. NDA beschikbaar op aanvraag voor projecten met gevoelige of concurrerende gegevensverzameling.
Leveringstermijn:
Basis: 2–3 dagen · Standaard: 5–7 dagen · Premium: 10 dagen
Wat er van de koper nodig is om te beginnen:
1. Doel-URL('s) of site('s) om te scrapen
2. Exacte velden die u nodig hebt — namen, prijzen, URL's, afbeeldingen, enz.
3. Gewenst uitvoerformaat — CSV, JSON, Google Sheets, database
4. Of het een eenmalige scrape of een terugkerende run is
Laten we het bouwen.
Stuur de doelsite en velden, en een werkende scraper-preview wordt binnen 48 uur verzonden — nul vooraf, geen risico. U ziet echte gegevens die van uw doelsite zijn geëxtraheerd voordat enige betaling verschuldigd is.
Zinner Kwaliteitsgarantie
Elke Zinner wordt beoordeeld en goedgekeurd voordat hij zich bij het platform aansluit.
Alle diensten worden ondersteund door onze kwaliteitsgarantie.
Uw betaling is beschermd totdat u het geleverde werk goedkeurt.
Pakketten vergelijken
| Functie | Basis | Standaard | Premium |
|---|---|---|---|
| Levertijd | 3 dagen | 7 dagen | 10 dagen |
| Revisies | 2 | 3 | 5 |
| Volledige broncode + installatie | ✓ | ✓ | ✓ |
| Eén doel-URL gescrapet | ✓ | ✓ | ✓ |
| Tot 10 velden per item geëxtraheerd | ✓ | ✕ | ✕ |
| Statische HTML-parsing (geen JS-rendering) | ✓ | ✓ | ✓ |
| CSV- of JSON-uitvoer | ✓ | ✕ | ✕ |
| Deduplicatie + veldnormalisatie | ✓ | ✓ | ✓ |
| Basis foutafhandeling en logging | ✓ | ✓ | ✓ |
| README | ✓ | ✓ | ✓ |
| Gestructureerd foutenlogboek + herhaalpogingwachtrij | ✕ | ✓ | ✓ |
| Meerdere pagina's crawlen met pagineringsondersteuning | ✕ | ✓ | ✓ |
| JavaScript-gerenderde pagina's (Puppeteer of Playwright) | ✕ | ✓ | ✓ |
| Anti-bot-afhandeling — UA-rotatie, headers, verzoekbeperking | ✕ | ✓ | ✓ |
| Ondersteuning voor proxyrotatie | ✕ | ✓ | ✓ |
| Rate-limit compliance met backoff op 429/503 | ✕ | ✓ | ✓ |
| Tot 25 velden per item | ✕ | ✓ | ✓ |
| Onbeperkt aantal records | ✕ | ✓ | ✓ |
| Output naar CSV, JSON of Google Sheets | ✕ | ✓ | ✓ |
| Prioritaire leveringsslot | ✕ | ✕ | ✓ |
| Onbeperkt aantal velden + aangepaste schematoewijzing | ✕ | ✕ | ✓ |
| Database-uitvoer — PostgreSQL, MySQL, MongoDB of SQLite | ✕ | ✕ | ✓ |
| Geplande runs — cron, GitHub Actions, AWS Lambda of Vercel | ✕ | ✕ | ✓ |
| Cron Wijzigingsdetectie tussen runs (nieuwe / bijgewerkte / verwijderde records) | ✕ | ✕ | ✓ |
| Ondersteuning voor content met inlogvereiste (sessiebeheer, formulierinzending) | ✕ | ✕ | ✓ |
| CAPTCHA-bewuste flow (handmatige oplossingsintegratie of externe oplosser) | ✕ | ✕ | ✓ |
| Docker-gebaseerde implementatie | ✕ | ✕ | ✓ |
| Monitoringdashboard of Slack/e-mailwaarschuwingen bij storing | ✕ | ✕ | ✓ |
| Loom-walkthrough van de volledige pijplijn | ✕ | ✕ | ✓ |
| 30 dagen ondersteuning na levering | ✕ | ✕ | ✓ |
Portfolio
Voorbeelden van het werk van de verkoper met betrekking tot deze Zinn.

SCRAPEHUB — Webscrapingscripts
Productieklare webscrapers gebouwd in Python en Node.js — extractie van één pagina, crawls van meerdere pagina's, JS-gerenderde sites, anti-bot-afhandeling en schone CSV-, JSON- of database-uitvoer. Realtime gegevensextractie met veerkrachtige selectors, herhalingslogica en gestructureerde foutregistratie.

SCRAPEHUB — Van doelsite naar schone gegevens
End-to-end scraping-pijplijn — ophalen van doel-URL, roterende user-agents en proxy-pools, selector-parsing, gegevensopschoning en -validatie, en uitvoer naar CSV, JSON of PostgreSQL. Gestructureerde logs volgen elke aanvraag, herhaling en voltooiing.

SCRAPEHUB — Gebouwd voor echte sites
Veerkrachtige scrapers met 429 backoff, 403 proxyrotatie, naleving van snelheidslimieten en dead-letter-wachtrijen. Gebouwd om Cloudflare, throttling en storingen tijdens het crawlen te overleven zonder gegevens te verliezen of stille fouten te retourneren. 99.6% slagingspercentage bij productiecrawls.

SCRAPEHUB — Schone uitvoerformaten
Gestructureerde uitvoer naar CSV, JSON, Excel, Google Sheets, PostgreSQL, MySQL, MongoDB, SQLite of Airtable. Deduplicatie, veldnormalisatie en schemavalidatie bij elke run — realtime synchronisatie, geplande runs en wijzigingsdetectie.

SCRAPEHUB — Geplande runs en monitoring
Terugkerende scrapes via cron, GitHub Actions, AWS Lambda of Vercel Cron. Wijzigingsdetectie markeert nieuwe, bijgewerkte of verwijderde records tussen runs, met Slack- of e-mailwaarschuwingen bij storing, zodat niets stilzwijgend kapotgaat. Volledige monitoring van de pijplijnstatus.

SCRAPEHUB — Volledige scraping-stack
Volledige scraping-architectuur — Python en Node.js met BeautifulSoup, Scrapy, Cheerio, Playwright, Puppeteer en Selenium; datapijplijnen via pandas en SQLAlchemy naar PostgreSQL, MongoDB, CSV of JSON; geïmplementeerd met Docker, GitHub Actions en cloud cron.
Extra informatie
Tech Stack
Wat is inbegrepen
Mijn proces
Servicedetails
Veelgestelde vragen
Vaak wel — met roterende proxy's, User-Agent spoofing, throttling en headless browser rendering. Sommige sites gebruiken geavanceerde botbeveiliging (Cloudflare Enterprise, Akamai, PerimeterX) die de kosten aanzienlijk verhoogt. Ik zal het doel beoordelen en u vooraf vertellen of het haalbaar is tegen standaardprijzen of een premium offerte vereist.
Het scrapen van openbare gegevens is over het algemeen legaal in de meeste rechtsgebieden, maar het hangt af van de voorwaarden van de site, wat u scrapt en hoe u de gegevens gebruikt. Ik scrap alleen openbare pagina's. Ik omzeil geen betaalmuren, scrap geen persoonlijke gegevens (PII) en overtreed geen expliciete anti-scraping voorwaarden zonder uw schriftelijke goedkeuring en juridische goedkeuring.
Selectors kunnen breken wanneer sites worden bijgewerkt. De scraper wordt geleverd met gestructureerde foutenlogging, zodat u onmiddellijk weet of een veld stopt met extraheren. Standaard en Premium omvatten veerkrachtpatronen (fallback selectors, waarschuwingen) die breuk verminderen. 14 dagen gratis fixes dekken eventuele lay-outwijzigingen na levering.
Ja — Puppeteer, Playwright of Selenium verwerken SPA's, lazy-loaded inhoud en oneindig scrollen. Dit is inbegrepen in de Standaard- en Premiumpakketten. Basic dekt alleen statische HTML.
Ja, voor accounts die u bezit of waarvoor u toegang hebt. Sessiebeheer, cookiebeheer en het indienen van formulieren zijn inbegrepen in Premium. Stuur inloggegevens via een veilige methode — ik bewaar ze nooit buiten de projectscope.
Twee opties — handmatige oplossingsintegratie waarbij ik pauzeer en u oplost, of een API van een externe CAPTCHA-oplosser (2Captcha, Anti-Captcha) op uw kosten. Inbegrepen in Premium; beschikbaar als add-on voor Standaard.
Ja — Premium omvat geplande runs via cron, GitHub Actions, AWS Lambda of Vercel Cron. De frequentie is aan u — dagelijks, wekelijks, maandelijks of aangepast. Elke run logt resultaten en kan u waarschuwen bij falen.
Snelheidsbeperkingsbeheer is ingebouwd — verzoekbeperking, exponentiële backoff bij 429/503-reacties en gelijktijdigheidsafstemming om onder de limiet te blijven. Standaard- en Premiumpakketten omvatten volledige snelheidsbeperkingslogica.
Ja — PostgreSQL, MySQL, MongoDB, SQLite of Airtable directe invoegingen worden ondersteund. Premium omvat database-uitvoer; Standaard ondersteunt CSV, JSON en Google Sheets.
Geen harde limiet — hangt af van de snelheidsbeperkingen van de site en de grootte van de proxy-pool. Ik heb scrapers uitgevoerd die 100,000+ records over meerdere dagen ophalen. Voor zeer grote crawls zal ik proxy-rotatie en planning aanbevelen om onder de detectiedrempels te blijven.
Volledig eigendom gaat over op de koper bij definitieve levering. Broncode, inloggegevens, implementatieconfiguraties en alle geschraapte gegevens worden overgedragen met de uiteindelijke betaling. Geen licentiebeperkingen, geen doorlopende kosten, geen vendor lock-in.
Elke scraper draait eerst op een kleine steekproef, daarna een volledige run. De uitvoer wordt gevalideerd tegen het verwachte schema — ontbrekende velden, dubbele rijen en parseerfouten worden gemarkeerd vóór levering. U krijgt het foutenlogboek en de succes-/foutsamenvatting, zodat niets verborgen blijft.
Ja. NDA beschikbaar op aanvraag — ideaal voor projecten met gevoelige of concurrerende gegevensverzameling. Deel uw NDA-sjabloon of vraag een wederzijdse aan. Ondertekend voordat code of details van de doelsite worden uitgewisseld.
Klantrecensies
Bekijk wat onze klanten zeggen over deze Zinn
Categorieën
Zinner Beleid
Gerelateerde Zinns
Ik zal WhatsApp Business API instellen en een professionele WhatsApp chatbot bouwen voor uw bedrijf
Ik zal aangepaste Shopify-automatisering, AI-chatbots en e-commerce software bouwen