
귀하의 하드웨어에 비공개 로컬 AI LLM을 배포하고 Python 자동화를 구축해 드립니다.
Ollama를 사용하여 PC에 개인 로컬 LLM(Qwen/Llama)을 설치합니다. 100% 오프라인 및 보안.
- 로컬 LLM 설정
- 문서 포함
- 100%오프라인 및 비공개
기본 기능에 더해 깔끔한 웹 UI(Open WebUI)와 맞춤형 Python 자동화 스크립트가 포함됩니다.
- 기본의 모든 것
- 웹 UI 포함
- 맞춤형 Python 스크립트
- 우선 지원
표준 기능에 더해 고급 하드웨어 최적화, 복잡한 Python 자동화, 1:1 기술 지원이 포함됩니다.
- 표준의 모든 것
- 하드웨어 최적화
- 고급 자동화
- 1:1 지원
맞춤 제안 요청하기
사전 판매 질문 하기
질문을 하려면 로그인하세요
플랫폼 스팸을 줄이기 위해 사전 판매 메시지는 로그인한 사용자만 보낼 수 있습니다.
무료 계정을 만들거나 로그인하여 이 Zinner에게 직접 메시지를 보내세요.
로그인 / 가입한눈에 보기
이 서비스에 대한 주요 정보로 결정을 내리는 데 도움을 드립니다. Zinn Hub에서 생성됨, 판매자가 아님.
가치 위치
배포 방법
Supported Models
개인 정보 보호 수준
배송 및 지원
받으실 내용
전체 설명
OpenAI 또는 Anthropic에 비싼 월별 구독료를 지불하는 데 지치셨습니까?
민감한 비즈니스 데이터가 클라우드로 전송되는 것이 걱정되십니까?
안녕하세요, 저는 DSEcho Studio (www.dsecho.cn)의 설립자인 Deep Stace Echo입니다. 저는 100%개인, 오프라인, 자체 호스팅 AI 시스템 구축을 전문으로 하는 하드코어 풀스택 개발자입니다.
저와 함께 작업하면 귀하의 하드웨어에서 전적으로 실행되는 시스템을 얻게 됩니다. 인터넷이 필요 없고, 데이터 유출이 없으며, 월별 API 요금이 전혀 없습니다.
얻게 될 것:
1. 로컬 AI 및 LLM 배포
Ollama를 사용하여 Qwen 또는 Llama와 같은 최첨단 오픈 소스 모델을 PC, Mac 또는 서버에 직접 배포하고 최적화합니다. 고급 GPU를 가지고 있든 CPU만 가지고 있든, 원활하게 실행되도록 올바른 모델과 양자화된 형식을 구성해 드립니다.
2. 맞춤형 AI 에이전트 프레임워크
저는 단순히 기본적인 챗봇을 설치하는 것이 아닙니다. 저는 다음과 같은 고급 기능을 갖춘 지능형 AI 에이전트를 구축합니다.
-
생체 기억 시스템: AI가 긴 대화를 기억하고 기존 컨텍스트 창 제한을 우회할 수 있도록 합니다.
-
자율 도구 생성: AI는 복잡한 작업을 자동으로 해결하기 위해 자체 Python 스크립트를 작성하고 실행할 수 있습니다.
3. Python 자동화 및 스크립팅
웹 데이터를 스크랩하거나, Excel 파일을 처리하거나, 반복적인 워크플로우를 자동화해야 합니까? 저는 상세한 문서와 함께 깔끔하고 효율적인 Python 스크립트를 작성하여 쉽게 유지 관리할 수 있도록 합니다.
내 프로세스:
-
논의: 귀하의 하드웨어 사양과 목표를 저에게 메시지로 보내주세요.
-
배포: 환경을 설정하고, 모델을 다운로드하고, 원격으로 설정을 구성하거나 원클릭 스크립트를 제공합니다.
-
테스트 및 배송: 시스템을 함께 테스트합니다. AI를 사용하는 방법과 업데이트하는 방법을 정확히 알 수 있도록 단계별 README(문서)를 제공합니다.
왜 저를 선택해야 할까요?
-
직접 소통: 코드를 작성하는 개발자와 직접 소통합니다. 중간상이나 에이전시가 없습니다.
-
깔끔하고 문서화된 코드: 저는 블랙박스가 아닌 진정한 가치를 제공합니다.
-
빠른 배송: 대부분의 배포 작업은 24-48시간 이내에 완료됩니다.
클라우드에 의존하는 것을 멈추세요. 오늘 당신만의 프라이빗 AI 인프라를 구축해 보세요!
주문 전에 메시지를 보내주세요 정확한 요구 사항을 논의하고 완벽하게 맞는지 확인할 수 있습니다.
Zinner 품질 보증
모든 Zinner는 플랫폼에 참여하기 전에 검토 및 승인됩니다.
모든 서비스는 당사의 품질 보증 약속으로 뒷받침됩니다.
배송된 작업을 승인할 때까지 결제가 보호됩니다.
패키지 비교
| 특징 | 기본 | 표준 AI 에이전트 및 자동화 | 프리미엄 맞춤형 AI 및 풀 스택 |
|---|---|---|---|
| 배송 시간 | 2일 | 3일 | 5일 |
| 수정 | 1 | 2 | 3 |
| 로컬 LLM 설정 | ✓ | ✕ | ✕ |
| 문서 포함 | ✓ | ✕ | ✕ |
| 100%오프라인 및 비공개 | ✓ | ✕ | ✕ |
| 기본 패키지의 모든 것 | ✕ | ✓ | ✕ |
| 웹 UI 포함 | ✕ | ✓ | ✕ |
| 사용자 정의 Python 스크립트 | ✕ | ✓ | ✕ |
| 우선 지원 | ✕ | ✓ | ✕ |
| 표준의 모든 것 | ✕ | ✕ | ✓ |
| 하드웨어 최적화 | ✕ | ✕ | ✓ |
| 고급 자동화 | ✕ | ✕ | ✓ |
| 1:1 지원 | ✕ | ✕ | ✓ |
포트폴리오
이 Zinn과 관련된 판매자의 작업 예시.
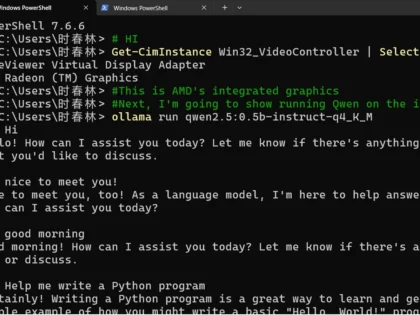
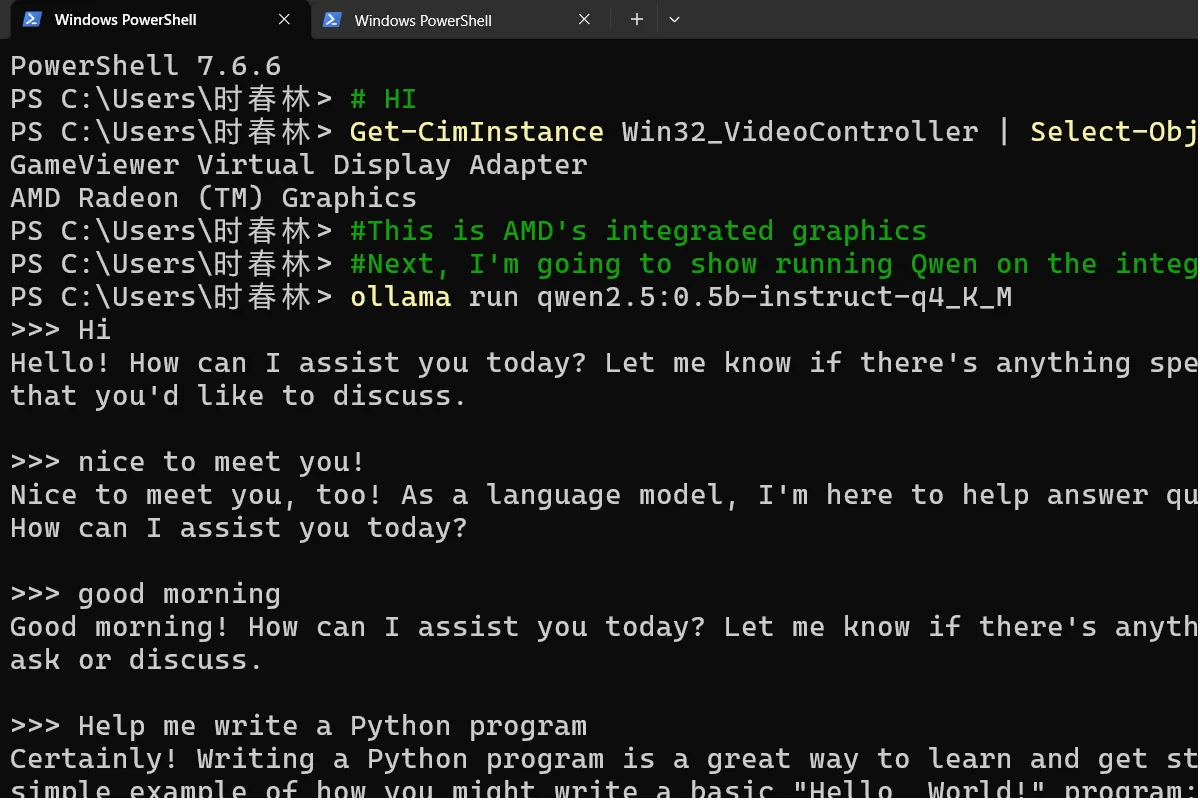
AMD 통합 그래픽(iGPU)에서 AI 모델 실행
로컬 LLM을 실행하고 싶지만 NVIDIA GPU가 없으신가요? Vulkan 또는 ROCm과 같은 기술을 사용하여 AMD 통합 그래픽에 AI 모델(Qwen/Llama 등)을 직접 배포하고 최적화할 수 있습니다. 100% 오프라인 및 비공개.
서비스 상세정보
자주 묻는 질문
주문 전에 메시지를 보내주세요! CPU/GPU 및 RAM을 분석하여 어떤 양자화된 모델(예: 4비트 또는 8비트 버전)이 컴퓨터에서 원활하게 실행되는지 확인합니다. 하드웨어에서 로컬 LLM을 실행할 수 없는 경우 전액 환불됩니다.
물론입니다. 설정이 완료되고 모델이 다운로드되면 인터넷 케이블을 뽑아도 AI는 완벽하게 작동합니다. 데이터는 절대 컴퓨터를 떠나지 않으므로 민감한 비즈니스 문서에 적합합니다.
고객 리뷰
이 Zinn에 대해 고객들이 무엇을 말하는지 확인하세요