

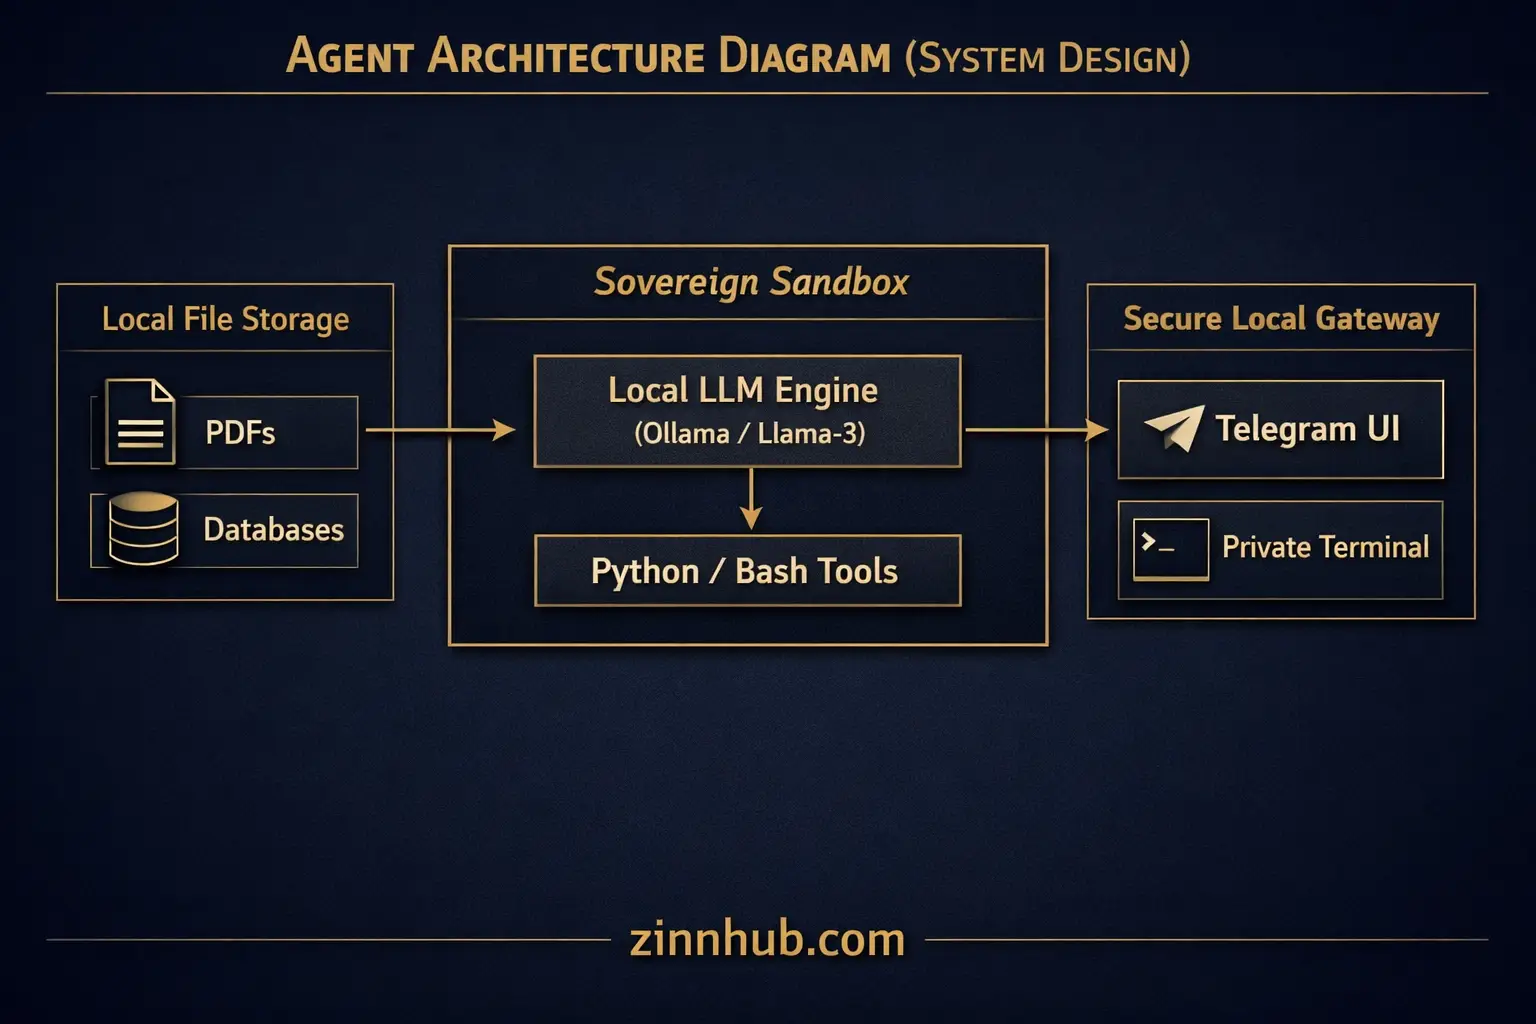
로컬 LLM 및 RAG 파이프라인을 실행하려면 하드웨어 리소스의 정밀한 균형이 필요합니다. 모델 매개변수가 사용 가능한 GPU VRAM 또는 시스템 RAM을 초과하면 OS가 시스템 스토리지를 사용해야 하므로 실행 속도가 거의 0으로 떨어집니다. 이것은…
한눈에 보기
이 서비스에 대한 주요 정보로 결정을 내리는 데 도움을 드립니다. Zinn Hub에서 생성됨, 판매자가 아님.
가치 위치
받는 것
빠른 처리
제공해야 할 사항
최고의 선택
전체 설명
로컬 LLM 및 RAG 파이프라인을 실행하려면 하드웨어 리소스의 정확한 균형이 필요합니다. 모델 매개변수가 사용 가능한 GPU VRAM 또는 시스템 RAM을 초과하면 OS가 시스템 저장소를 사용하도록 강제되어 실행 속도가 거의 0에 가까워집니다.
이 Micro Zinn은 소프트웨어를 구매하거나 설치하기 전에 하드웨어의 완전한 호환성 감사를 제공합니다. Apple Silicon Mac, NVIDIA CUDA 워크스테이션 또는 표준 Windows/Linux 서버 등 물리적 시스템을 평가하여 최적의 로컬 성능을 달성하는 방법을 정확히 알려드립니다.
분석 내용:
1. GPU VRAM 제약: 최대 모델 매개변수 한계(예: 7B, 13B 또는 34B 모델)를 찾기 위해 전용 그래픽 메모리를 매핑합니다.
2. 시스템 RAM 할당: 전용 GPU가 없거나 공유 시스템 메모리에서 실행되는 경우 CPU 추론 임계값 및 오프로딩 한계를 결정합니다.
3. 양자화 매핑: 처리 속도와 모델 지능의 균형을 맞추기 위해 정확한 양자화 수준(예: Q4_K_M, Q5_K_M 또는 Q8_0)을 권장합니다.
4. 컨텍스트 창 제한: 대량 문서 검색 중 시스템 메모리 부족 충돌을 방지하기 위해 안전한 최대 토큰 한계를 계산합니다.
어떤 오픈소스 가중치를 다운로드할지 또는 로컬 설정이 느린 이유를 추측하지 마세요. 매일 물리적 금속에서 이러한 시스템을 구축하는 운영자로부터 로컬 AI 환경을 위한 엔지니어링된 하드웨어 특화 맵을 얻으세요.
Ollama 모델 매개변수 제한, 컨텍스트 윈도우 스케일, 128GB RAM에 대한 최적 Q4/Q5 양자화를 매핑하는 완료된 하드웨어 호환성 감사.
예시 보기 ↗Micro Zinn은 작은 고정 가격의 시식 또는 마이크로 서비스입니다. CAVOK_Designs는 다음 가격으로 제공합니다:
기술 쇼케이스포트폴리오 빌더신규 고객 환영Zinner 품질 보증
모든 Zinner는 플랫폼에 참여하기 전에 검토 및 승인됩니다.
모든 서비스는 당사의 품질 보증 약속으로 뒷받침됩니다.
배송된 작업을 승인할 때까지 결제가 보호됩니다.
고객 리뷰
이 Zinn에 대해 고객들이 무엇을 말하는지 확인하세요

