

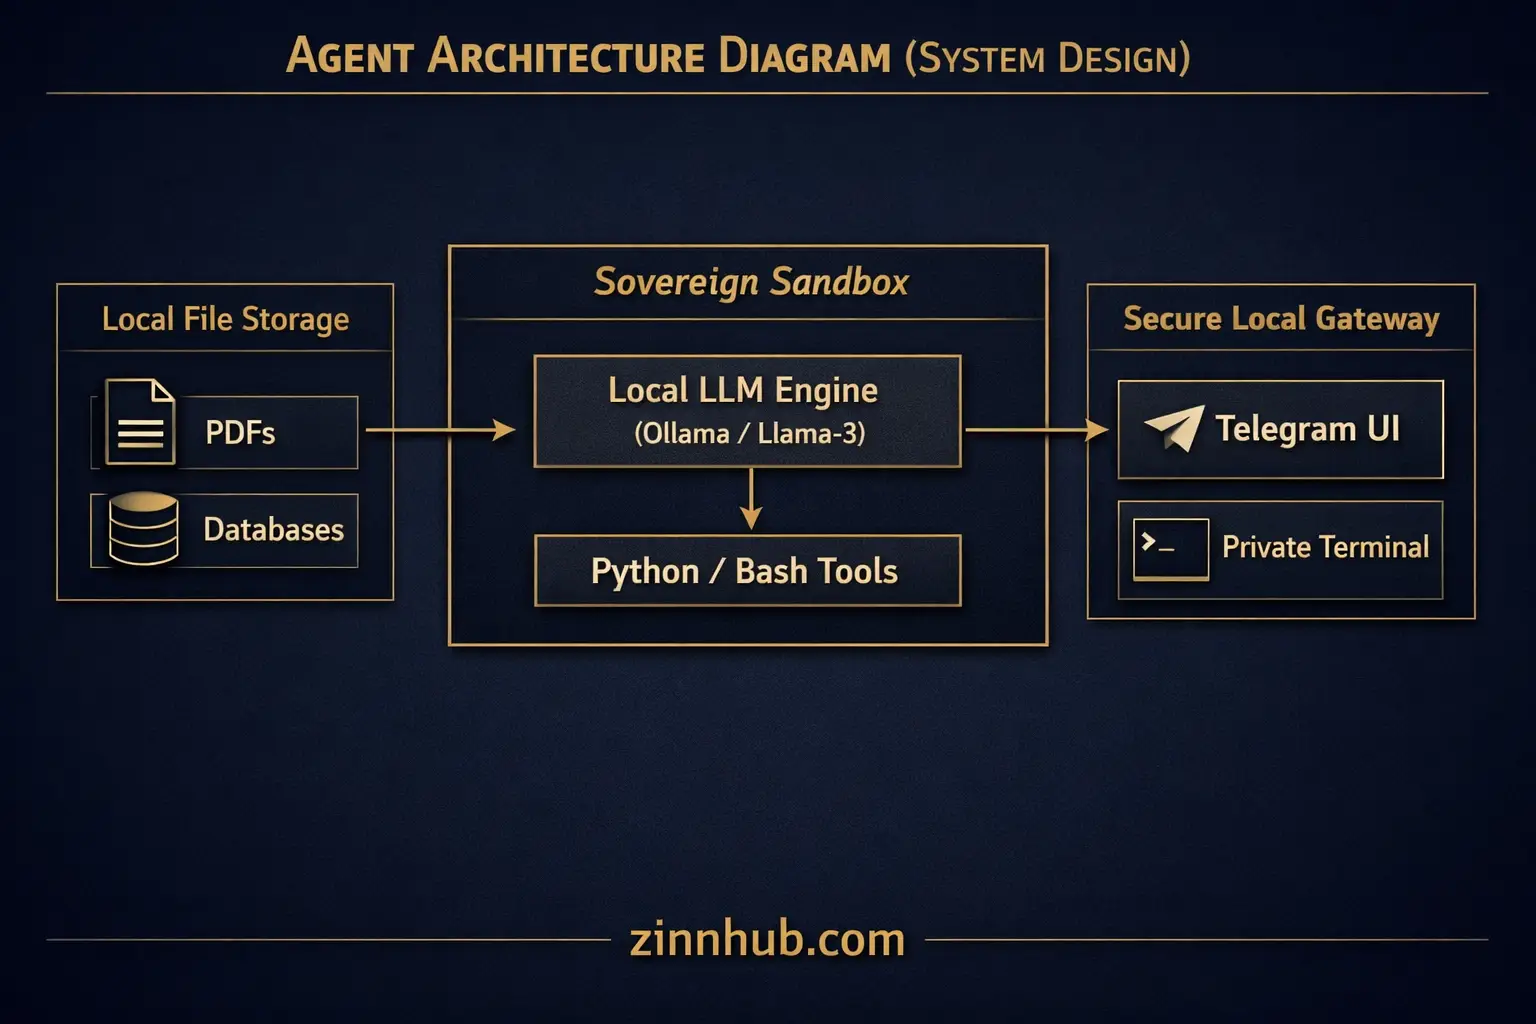
Menjalankan LLM lokal dan pipeline RAG membutuhkan keseimbangan sumber daya perangkat keras yang tepat. Jika parameter model Anda melebihi VRAM GPU atau RAM sistem yang tersedia, kecepatan eksekusi turun mendekati nol karena OS Anda dipaksa untuk menggunakan penyimpanan sistem. Ini…
Saya akan melakukan audit kompatibilitas perangkat keras & model lokal
Minta Penawaran Kustom
Masuk untuk Meminta Penawaran Kustom
Buat akun gratis atau masuk untuk meminta penawaran yang dipersonalisasi dari Zinner ini.
Masuk / DaftarAjukan Pertanyaan Pra-Penjualan
Masuk untuk Bertanya
Untuk mengurangi spam platform, pesan pra-penjualan hanya dapat dikirim oleh pengguna yang masuk.
Buat akun gratis atau masuk untuk mengirim pesan langsung ke Zinner ini.
Masuk / DaftarDiperlukan login
Buat akun gratis atau masuk untuk meminta penawaran yang dipersonalisasi.
Masuk / DaftarSekilas
Detail penting tentang layanan ini untuk membantu Anda memutuskan. Dihasilkan oleh Zinn Hub, bukan penjual.
Posisi Nilai
Apa yang Anda Terima
Penyelesaian Cepat
Apa yang Perlu Anda Sediakan
Terbaik Untuk
Deskripsi Lengkap
Menjalankan LLM lokal dan pipeline RAG membutuhkan keseimbangan sumber daya perangkat keras yang tepat. Jika parameter model Anda melebihi VRAM GPU atau RAM sistem yang tersedia, kecepatan eksekusi akan turun mendekati nol karena OS Anda dipaksa untuk menggunakan penyimpanan sistem.
Micro Zinn ini menyediakan audit kompatibilitas lengkap perangkat keras Anda sebelum Anda membeli atau menginstal perangkat lunak apa pun. Kami mengevaluasi sistem fisik Anda—apakah itu Apple Silicon Mac, workstation NVIDIA CUDA, atau server Windows/Linux standar—untuk memberi tahu Anda dengan tepat cara mencapai kinerja lokal yang optimal.
Apa yang kami analisis:
1. Batasan VRAM GPU: Kami memetakan memori grafis khusus Anda untuk menemukan batas parameter model maksimum Anda (misalnya, model 7B, 13B, atau 34B).
2. Alokasi RAM Sistem: Kami menentukan ambang batas inferensi CPU Anda dan batas offloading jika Anda tidak memiliki GPU khusus atau berjalan pada memori sistem bersama.
3. Pemetaan Kuantisasi: Kami merekomendasikan tingkat kuantisasi yang tepat (seperti Q4_K_M, Q5_K_M, atau Q8_0) untuk menyeimbangkan kecepatan pemrosesan dan kecerdasan model.
4. Batas jendela konteks: Kami menghitung batas token maksimum aman Anda untuk mencegah crash kehabisan memori sistem selama pengambilan dokumen yang berat.
Berhentilah menebak bobot sumber terbuka mana yang harus diunduh atau mengapa pengaturan lokal Anda lambat. Dapatkan peta yang direkayasa dan spesifik perangkat keras untuk lingkungan AI lokal Anda dari operator yang membangun sistem ini pada perangkat keras fisik setiap hari.
Audit kompatibilitas perangkat keras selesai memetakan batas parameter model Ollama, skala jendela konteks, dan kuantisasi Q4/Q5 optimal untuk RAM 128GB.
Lihat contoh ↗Micro Zinn adalah layanan kecil, harga tetap, atau layanan mikro. CAVOK_Designs menawarkan yang satu ini untuk:
Pameran keterampilanPembuat portofolioTerbuka untuk klien baruJaminan Kualitas Zinner
Setiap Zinner ditinjau dan disetujui sebelum bergabung dengan platform.
Semua layanan didukung oleh komitmen jaminan kualitas kami.
Pembayaran Anda dilindungi sampai Anda menyetujui pekerjaan yang telah diselesaikan.
Ulasan Pelanggan
Lihat apa kata pelanggan kami tentang Zinn ini

