

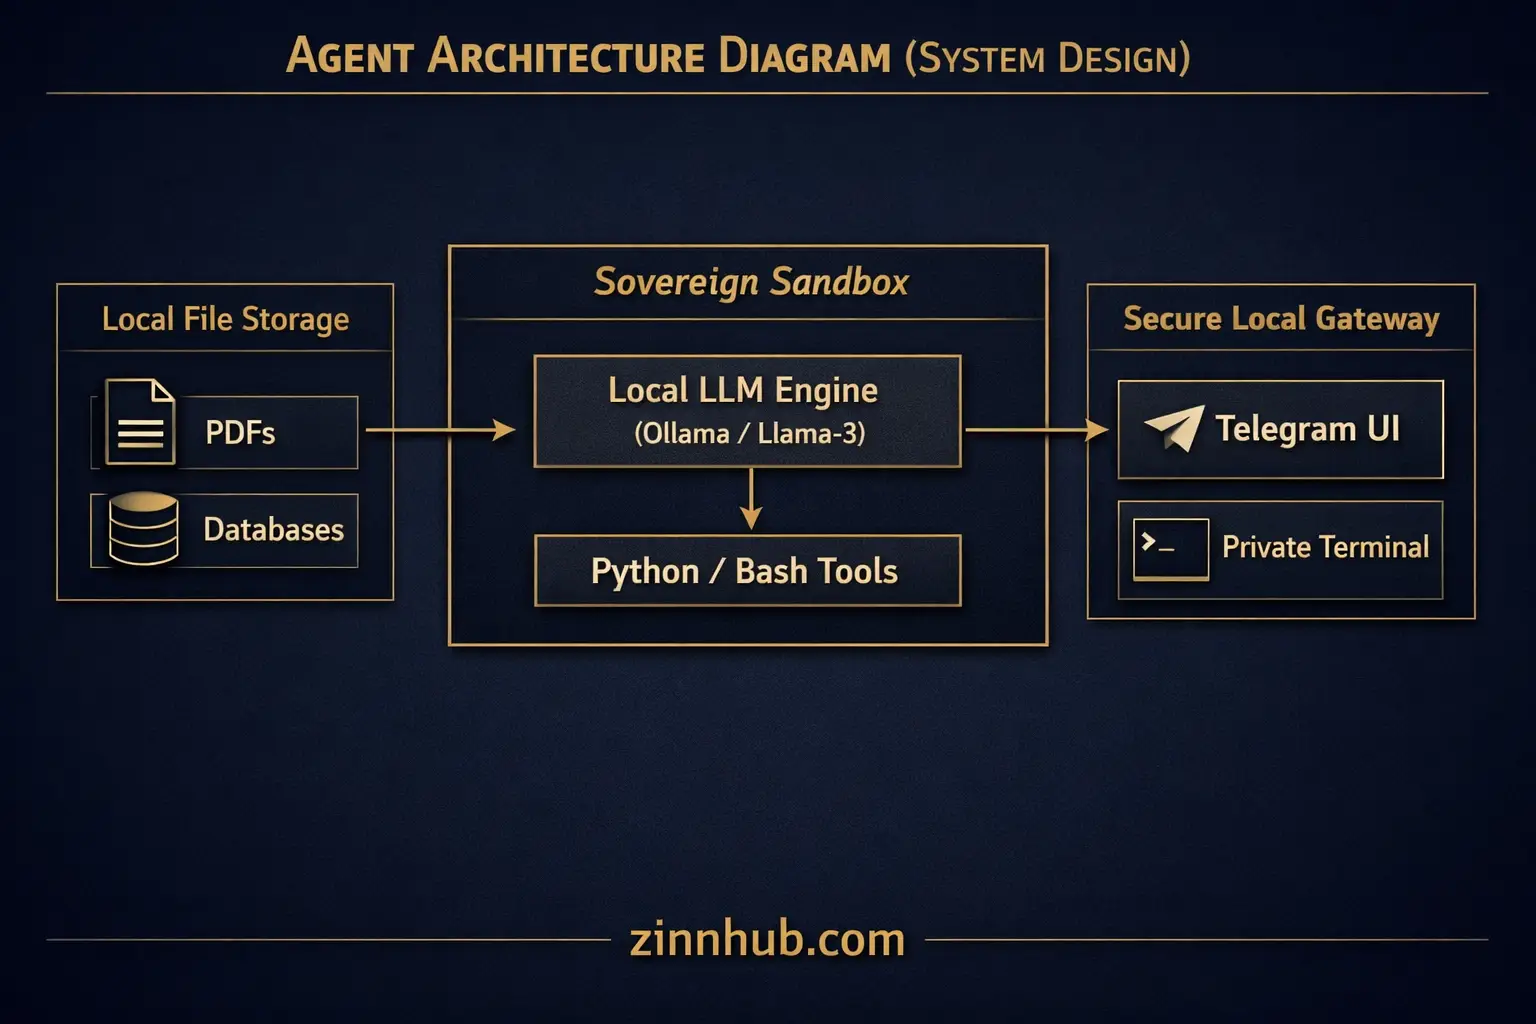
Ang pagpapatakbo ng mga lokal na LLM at RAG pipeline ay nangangailangan ng tumpak na balanse ng mga mapagkukunan ng hardware. Kung ang iyong mga parameter ng modelo ay lumampas sa iyong magagamit na GPU VRAM o system RAM, ang bilis ng pagpapatupad ay bumaba sa halos zero dahil napipilitan ang iyong OS na gumamit ng system storage. Ito…
Magsasagawa ako ng local hardware & model compatibility audit
Humiling ng Custom na Alok
Mag-log In para Humiling ng Custom na Alok
Gumawa ng libreng account o mag-log in para humiling ng personalized na alok mula sa Zinner na ito.
Mag-log In / MagrehistroMagtanong ng Pre-Sale Question
Mag-log In para Magtanong
Upang mabawasan ang spam sa platform, ang mga mensahe bago ang pagbebenta ay maaari lamang ipadala ng mga naka-log in na user.
Gumawa ng libreng account o mag-log in para direktang mag-mensahe sa Zinner na ito.
Mag-log In / MagrehistroKinakailangan ang pag-log in
Gumawa ng libreng account o mag-log in para mag-message sa Zinner na ito.
Mag-log In / MagrehistroKinakailangan ang pag-log in
Gumawa ng libreng account o mag-log in para humiling ng personalized na alok.
Mag-log In / MagrehistroSa Isang Sulyap
Mga pangunahing detalye tungkol sa serbisyong ito upang matulungan kang magpasya. Binuo ng Zinn Hub, hindi ng nagbebenta.
Posisyon ng Halaga
Ano ang Matatanggap Mo
Mabilis na Pagkumpleto
Ano ang Kailangan Mong Ibigay
Pinakamahusay Para sa
Buong Deskripsyon
Ang pagpapatakbo ng mga lokal na LLM at RAG pipeline ay nangangailangan ng tumpak na balanse ng mga mapagkukunan ng hardware. Kung ang iyong mga parameter ng modelo ay lumampas sa iyong magagamit na GPU VRAM o system RAM, ang bilis ng pagpapatupad ay bumaba sa halos zero dahil napipilitan ang iyong OS na gumamit ng system storage.
Ang Micro Zinn na ito ay nagbibigay ng kumpletong compatibility audit ng iyong hardware bago ka bumili o mag-install ng anumang software. Sinusuri namin ang iyong pisikal na sistema—kung ito ay isang Apple Silicon Mac, isang NVIDIA CUDA workstation, o isang standard na Windows/Linux server—upang sabihin sa iyo kung paano eksaktong makamit ang optimal na lokal na performance.
Ano ang aming sinusuri:
1. Mga limitasyon ng GPU VRAM: Iminamapa namin ang iyong dedikadong graphics memory upang mahanap ang iyong maximum na model parameter ceiling (hal., 7B, 13B, o 34B na modelo).
2. Paglalaan ng System RAM: Tinutukoy namin ang iyong mga threshold ng CPU-inference at mga limitasyon ng offloading kung wala kang dedikadong GPU o tumatakbo sa shared system memory.
3. Quantization mapping: Inirerekomenda namin ang eksaktong antas ng quantization (tulad ng Q4_K_M, Q5_K_M, o Q8_0) upang balansehin ang bilis ng pagproseso at katalinuhan ng modelo.
4. Mga limitasyon ng context window: Kinakalkula namin ang iyong ligtas na maximum na limitasyon ng token upang maiwasan ang mga pag-crash ng system out-of-memory sa panahon ng mabigat na pagkuha ng dokumento.
Itigil ang paghula kung aling mga open-source na timbang ang ida-download o kung bakit mabagal ang iyong lokal na setup. Kumuha ng inhenyero, hardware-specific na mapa para sa iyong lokal na AI environment mula sa mga operator na bumubuo ng mga sistemang ito sa pisikal na metal araw-araw.
Nakumpleto ang hardware compatibility audit na nagmamapa sa mga limitasyon ng parameter ng modelo ng Ollama, mga sukat ng window ng konteksto, at optimal na Q4/Q5 quantizations para sa 128GB RAM.
Tingnan ang halimbawa ↗Ang Micro Zinn ay isang maliit, nakapirming presyo na panlasa o micro serbisyo. Inaalok ito ng CAVOK_Designs para sa:
Pagpapakita ng mga kasanayanTagabuo ng portfolioBukas sa mga bagong kliyenteZinner Quality Guarantee
Bawat Zinner ay sinusuri at aprubado bago sumali sa platform.
Ang lahat ng serbisyo ay sinusuportahan ng aming pangako sa kalidad ng katiyakan.
Protektado ang iyong bayad hanggang sa aprubahan mo ang naihatid na trabaho.
Mga Review ng Customer
Tingnan kung ano ang sinasabi ng aming mga customer tungkol sa Zinn na ito

