RAG & నాలెడ్జ్ బేస్ నిపుణులను నియమించుకోండి
మీ సంస్థ యొక్క జ్ఞానం పత్రాలు, వికీలు, డేటాబేస్లు మరియు ఫైల్ సిస్టమ్లలో లాక్ చేయబడింది, వీటిని AI మోడల్లు డిఫాల్ట్గా యాక్సెస్ చేయలేవు — మరియు మీ నిర్దిష్ట డేటా నుండి ప్రశ్నలకు ఖచ్చితంగా సమాధానం ఇచ్చే AI సిస్టమ్లను నిర్మించడానికి ఏకైక మార్గం రిట్రీవల్ ఆగ్మెంటెడ్ జనరేషన్. RAG అనేది ఒక సాధారణ-ప్రయోజన AI మోడల్ను మీ వ్యాపారంపై నిపుణుడిగా మార్చే ఆర్కిటెక్చర్, ఇది ప్రశ్న సమయంలో మీ పత్రాలకు కనెక్ట్ చేయడం ద్వారా, సాధారణ ప్రతిస్పందనలు లేదా భ్రమ కలిగించే సమాచారం కాకుండా ఆధారిత, ఖచ్చితమైన, ఉటంకించదగిన సమాధానాలను అందించడానికి అవసరమైన సందర్భాన్ని అందిస్తుంది.
Zinn Hubలో, అనుభవజ్ఞులైన AI ఇంజనీర్లు కస్టమ్ RAG పైప్లైన్లు, వెక్టర్ డేటాబేస్ సిస్టమ్లు, డాక్యుమెంట్ ఇన్జెషన్ వర్క్ఫ్లోలు, నాలెడ్జ్ బేస్ చాట్బాట్లు, హైబ్రిడ్ సెర్చ్ ఇంప్లిమెంటేషన్లు మరియు మూల్యాంకన ఫ్రేమ్వర్క్లను నిర్మిస్తారు, ఇవి మీ సంస్థాగత జ్ఞానాన్ని సహజ భాష ద్వారా శోధించదగినవిగా చేస్తాయి. వీరు పూర్తి RAG స్టాక్ను అర్థం చేసుకున్న నిపుణులు — డాక్యుమెంట్ పార్సింగ్, చంకింగ్ వ్యూహాలు, ఎంబెడింగ్ మోడల్లు, వెక్టర్ డేటాబేస్లు, రిట్రీవల్ అల్గారిథమ్లు, గ్రౌండెడ్ జనరేషన్ కోసం ప్రాంప్ట్ ఇంజనీరింగ్ మరియు నమ్మదగిన సిస్టమ్లను నమ్మదగని వాటి నుండి వేరుచేసే మూల్యాంకన పద్దతి. ప్రతి లిస్టింగ్లో క్రిప్టోతో చెల్లించండి మరియు మీ మొదటి $500 కమీషన్ రహితం.
మీ వ్యాపారం కోసం RAG ఎందుకు ముఖ్యమైనది
ప్రతి సంస్థకు జ్ఞాన సమస్య ఉంది — కీలక సమాచారం డాక్యుమెంటేషన్, విధానాలు, సహాయ కథనాలు, అంతర్గత వికీలు, స్లాక్ థ్రెడ్లు, ఇమెయిల్ ఆర్కైవ్లు మరియు వ్యక్తిగత నైపుణ్యం అంతటా చెల్లాచెదురుగా ఉంది. ఉద్యోగులు సంస్థలో ఎక్కడో ఉన్నప్పటికీ కనుగొనడం కష్టంగా ఉన్న సమాధానాల కోసం గంటల తరబడి వెతుకుతారు. ఏజెంట్లు మాన్యువల్గా నాలెడ్జ్ బేస్ల ద్వారా శోధిస్తున్నప్పుడు కస్టమర్లు మద్దతు ప్రతిస్పందనల కోసం వేచి ఉంటారు. సంస్థాగత జ్ఞానం డాక్యుమెంట్ చేయబడనందున లేదా పాతిపెట్టబడినందున కొత్త బృంద సభ్యులు వేగవంతం కావడానికి నెలలు పడుతుంది. RAG దీనిని పరిష్కరిస్తుంది మీ ప్రస్తుత జ్ఞానంపై AI లేయర్ను సృష్టించడం ద్వారా ఎవరైనా సహజ భాషలో ప్రశ్నించవచ్చు. డజన్ల కొద్దీ డాక్యుమెంట్ల ద్వారా శోధించడం మరియు సరైన కీలకపదాలు సరిపోతాయని ఆశించడం కంటే, వినియోగదారులు సహజంగా ప్రశ్నలు అడుగుతారు మరియు మూల డాక్యుమెంట్లను సూచించే ఉల్లేఖనాలతో ఖచ్చితమైన సమాధానాలను పొందుతారు. AI ఊహించదు — ఇది మీ డేటా నుండి సంబంధిత భాగాలను తిరిగి పొందుతుంది మరియు ఆ సాక్ష్యం ఆధారంగా సమాధానాలను ఉత్పత్తి చేస్తుంది. ఇది మీ నిర్దిష్ట వ్యాపారం గురించి ఏమీ తెలియని ChatGPTకి ఉద్యోగులకు ప్రాప్యతను ఇవ్వడం నుండి ప్రాథమికంగా భిన్నంగా ఉంటుంది. మీ డాక్యుమెంటేషన్పై శిక్షణ పొందిన RAG సిస్టమ్ మీ ఉత్పత్తులు, ప్రక్రియలు, విధానాలు మరియు పద్ధతులపై ఎల్లప్పుడూ అందుబాటులో ఉండే నిపుణుడిగా మారుతుంది — ఇది స్థిరంగా సమాధానం ఇస్తుంది, ఎప్పటికీ మర్చిపోదు మరియు మీ సంస్థలోని ప్రతి వ్యక్తికి ఏకకాలంలో సేవ చేయడానికి స్కేల్ చేస్తుంది.
Zinn Hubలో RAG & నాలెడ్జ్ బేస్ సేవలు
- కస్టమ్ RAG పైప్లైన్ డెవలప్మెంట్ — మీ డాక్యుమెంట్లను AI మోడల్లకు కనెక్ట్ చేసే ఎండ్-టు-ఎండ్ రిట్రీవల్ ఆగ్మెంటెడ్ జనరేషన్ సిస్టమ్స్. డాక్యుమెంట్ ఇన్జెషన్, చంకింగ్, ఎంబెడింగ్, వెక్టర్ స్టోరేజ్, రిట్రీవల్, ప్రాంప్ట్ ఇంజనీరింగ్ మరియు సైటేషన్ సపోర్ట్తో ఆన్సర్ జనరేషన్.
- వెక్టర్ డేటాబేస్ సెటప్ & కాన్ఫిగరేషన్ — పైన్కోన్, వీవియేట్, క్వాడ్రాంట్, మిల్వస్, క్రోమాడిబి లేదా పిజివెక్టర్ ఇన్స్టాలేషన్, స్కీమా డిజైన్, ఇండెక్సింగ్ వ్యూహాలు, మెటాడేటా ఫిల్టరింగ్, నేమ్స్పేస్ కాన్ఫిగరేషన్ మరియు క్వెరీ పనితీరు ఆప్టిమైజేషన్.
- డాక్యుమెంట్ ఇన్జెషన్ పైప్లైన్లు — PDFలు, Word డాక్యుమెంట్లు, స్ప్రెడ్షీట్లు, వెబ్ పేజీలు, కాన్ఫ్లూయెన్స్, నోషన్, షేర్పాయింట్, Google డ్రైవ్ మరియు ఇతర మూలాల స్వయంచాలక ప్రాసెసింగ్, మార్పు గుర్తింపు మరియు ఇంక్రిమెంటల్ రీ-ఇండెక్సింగ్తో ముక్కలు చేయబడిన, పొందుపరచబడిన, సూచిక చేయబడిన కంటెంట్గా.
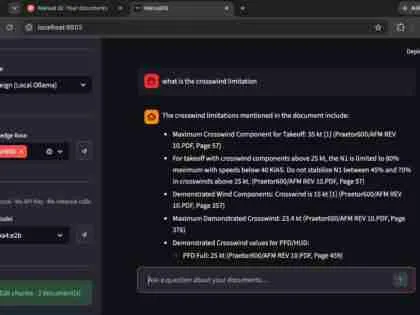
- AI-శక్తితో కూడిన డాక్యుమెంట్ Q&A సిస్టమ్స్ — చాట్ లేదా శోధన ఇంటర్ఫేస్లు, ఇక్కడ వినియోగదారులు సహజ భాషా ప్రశ్నలను అడుగుతారు మరియు మీ డాక్యుమెంటేషన్ నుండి ఉల్లేఖనాలు, విశ్వసనీయ స్కోర్లు మరియు మూల సామగ్రికి లింక్లతో ఖచ్చితమైన సమాధానాలను పొందుతారు.
- నాలెడ్జ్ బేస్ చాట్బాట్లు — కస్టమర్-ఫేసింగ్ లేదా అంతర్గత AI సహాయకులు మీ నాలెడ్జ్ బేస్, ఉత్పత్తి డాక్యుమెంట్లు, సహాయ కేంద్రం, SOPలు లేదా పాలసీ డాక్యుమెంట్ల నుండి ప్రశ్నలకు బ్రాండెడ్ ఇంటర్ఫేస్లు, సంభాషణ చరిత్ర మరియు అభిప్రాయ సేకరణతో సమాధానం ఇస్తారు.
- హైబ్రిడ్ సెర్చ్ ఇంప్లిమెంటేషన్ — సెమాంటిక్ అర్థం మరియు ఖచ్చితమైన పదజాలం, సాంకేతిక పరిభాష మరియు స్వచ్ఛమైన వెక్టర్ సెర్చ్ మిస్ చేయగల సరైన నామవాచకాలను రెండింటినీ నిర్వహించే రిట్రీవల్ కోసం BM25 కీవర్డ్ సెర్చ్తో వెక్టర్ సారూప్యత సెర్చ్ను కలపడం.
- చంకింగ్ స్ట్రాటజీ ఆప్టిమైజేషన్ — మీ కంటెంట్ రకాలకు వ్యతిరేకంగా స్థిర-పరిమాణం, సెమాంటిక్, రికర్సివ్ మరియు పేరెంట్-చైల్డ్ చంకింగ్ విధానాల యొక్క క్రమబద్ధమైన పరీక్ష, సరైన వ్యూహాన్ని నిర్ణయించడానికి పరిమాణాత్మక ఖచ్చితత్వ పోలికలతో.
- ఎంబెడింగ్ మోడల్ ఎంపిక & ఫైన్-ట్యూనింగ్ — మీ డేటాకు వ్యతిరేకంగా OpenAI, Cohere, Voyage, BGE, E5 మరియు ఇతర ఎంబెడింగ్ మోడల్లను బెంచ్మార్కింగ్ చేయడం. మెరుగైన రిట్రీవల్ ఔచిత్యం కోసం మీ డొమైన్ పదజాలంపై ఐచ్ఛిక ఫైన్-ట్యూనింగ్.
- మల్టీ-మోడల్ RAG సిస్టమ్స్ — టెక్స్ట్తో పాటు చిత్రాలు, రేఖాచిత్రాలు, చార్ట్లు మరియు పట్టికలపై తిరిగి పొందడం, మీ పత్రాలలో పొందుపరిచిన దృశ్య కంటెంట్ గురించి ప్రశ్నలకు సమాధానం ఇవ్వడానికి AIని అనుమతిస్తుంది.
- RAG మూల్యాంకనం & పర్యవేక్షణ — రిట్రీవల్ ఖచ్చితత్వం, సమాధానం సరైనది, భ్రాంతి రేట్లు మరియు ప్రతిస్పందన నాణ్యతను కొలిచే ఆటోమేటెడ్ మూల్యాంకన పైప్లైన్లు. ఖచ్చితత్వ ట్రాకింగ్, లేటెన్సీ మెట్రిక్లు మరియు వినియోగ విశ్లేషణలతో ఉత్పత్తి పర్యవేక్షణ డాష్బోర్డ్లు.
RAG ఆర్కిటెక్చర్ లేయర్లు
ఒక ఉత్పత్తి RAG సిస్టమ్ బహుళ సాంకేతిక పొరలను కలిగి ఉంటుంది, ఇవి ప్రతి ఒక్కటి సమాధాన నాణ్యతను ప్రభావితం చేస్తాయి. ఇన్జెషన్ లేయర్ డాక్యుమెంట్ పార్సింగ్, క్లీనింగ్ మరియు చంకింగ్ను నిర్వహిస్తుంది. ఎంబెడింగ్ లేయర్ టెక్స్ట్ చంక్లను వెక్టర్ ప్రాతినిధ్యాలుగా మారుస్తుంది. స్టోరేజ్ లేయర్ — వెక్టర్ డేటాబేస్ — వేగవంతమైన సారూప్యత శోధన కోసం ఈ వెక్టర్స్ను ఇండెక్స్ చేస్తుంది మరియు అందిస్తుంది. రిట్రీవల్ లేయర్ శోధన వ్యూహాలను మిళితం చేస్తుంది, ఫిల్టర్లను వర్తింపజేస్తుంది మరియు ఫలితాలను ర్యాంక్ చేస్తుంది. జనరేషన్ లేయర్ AI మోడల్ యొక్క ప్రతిస్పందనను తిరిగి పొందిన సందర్భంలో ఆధారపడటానికి ప్రాంప్ట్ ఇంజనీరింగ్ను ఉపయోగిస్తుంది. మరియు మూల్యాంకన లేయర్ ఎండ్-టు-ఎండ్ నాణ్యతను కొలుస్తుంది. ఏదైనా లేయర్లో బలహీనత మొత్తం సిస్టమ్ను క్షీణింపజేస్తుంది, అందుకే RAGకు ఒక భాగం మాత్రమే కాకుండా పూర్తి స్టాక్ను అర్థం చేసుకునే నిపుణులు అవసరం.
సంబంధిత సేవలు
RAG మరియు నాలెడ్జ్ బేస్ డెవలప్మెంట్ Zinn Hubలోని ఇతర AI మరియు డెవలప్మెంట్ సేవలతో కనెక్ట్ అవుతుంది. మీ RAG సిస్టమ్ యొక్క జనరేషన్ లేయర్కు శక్తినిచ్చే ప్రాంప్ట్ల కోసం, ప్రాంప్ట్ ఇంజనీరింగ్ సేవలను బ్రౌజ్ చేయండి. RAG ప్రశ్నలను ట్రిగ్గర్ చేసే మరియు ఫలితాలను ప్రాసెస్ చేసే ఆటోమేటెడ్ వర్క్ఫ్లోల కోసం, AI ఆటోమేషన్ మరియు వర్క్ఫ్లో సేవలను చూడండి. కోడ్ లేకుండా RAG-శక్తితో కూడిన ఇంటర్ఫేస్లను నిర్మించడానికి, నో-కోడ్ మరియు లో-కోడ్ డెవలప్మెంట్ను అన్వేషించండి. RAGకి అనుబంధంగా ఉండే అనుకూల AI మోడల్ శిక్షణ మరియు ఫైన్-ట్యూనింగ్ కోసం, AI డెవలప్మెంట్ పేరెంట్ కేటగిరీని బ్రౌజ్ చేయండి. స్వీయ-నిర్వహణ వెక్టర్ డేటాబేస్లు మరియు RAG పైప్లైన్లను హోస్ట్ చేసే సర్వర్ ఇన్ఫ్రాస్ట్రక్చర్ కోసం, Linux సర్వర్ అడ్మినిస్ట్రేషన్ చూడండి. RAG సిస్టమ్ల కోసం డిప్లాయ్మెంట్ పైప్లైన్లు మరియు ఇన్ఫ్రాస్ట్రక్చర్-యాజ్-కోడ్ కోసం, DevOps ఇంజనీరింగ్ సేవలను బ్రౌజ్ చేయండి.
మీరు అనుభవజ్ఞుడైన RAG ఇంజనీర్నా? జిన్ హబ్లో RAG మరియు నాలెడ్జ్ బేస్ సేవలను విక్రయించడం ప్రారంభించండి మరియు కస్టమ్ రిట్రీవల్ ఆగ్మెంటెడ్ జనరేషన్ సిస్టమ్స్, వెక్టర్ డేటాబేస్ నైపుణ్యం మరియు AI-శక్తితో కూడిన డాక్యుమెంట్ సెర్చ్ అవసరమయ్యే ప్రపంచవ్యాప్త వ్యాపారాలతో కనెక్ట్ అవ్వండి. జిన్నర్గా ఉచితంగా నమోదు చేసుకోండి మరియు ఈరోజే లిస్టింగ్ ప్రారంభించండి.
RAG & నాలెడ్జ్ బేస్ స్పెషలిస్ట్ను ఎలా నియమించుకోవాలి
మీ డేటా మూలాధారాలు మరియు వినియోగ సందర్భాన్ని నిర్వచించండి మీ AI సిస్టమ్ శోధించాల్సిన పత్రాలు మరియు డేటాను గుర్తించండి — PDFలు, సహాయ కథనాలు, వికీలు, డేటాబేస్లు, వెబ్ పేజీలు లేదా అంతర్గత డాక్యుమెంటేషన్. వినియోగదారులు సిస్టమ్తో ఎలా సంభాషిస్తారో నిర్వచించండి మరియు ఖచ్చితత్వ అవసరాలు మరియు ఆశించిన ప్రశ్న రకాలను పేర్కొనండి.
RAG స్పెషలిస్ట్ను ఎంచుకోండి Zinn Hubలో RAG మరియు నాలెడ్జ్ బేస్ సేవలను బ్రౌజ్ చేయండి. మీ డాక్యుమెంట్ రకాలు, డేటా వాల్యూమ్ మరియు డిప్లాయ్మెంట్ ఎన్విరాన్మెంట్తో అనుభవం కోసం పోర్ట్ఫోలియోలను సమీక్షించండి. సమాధానం ఖచ్చితత్వం మరియు సిస్టమ్ విశ్వసనీయత కోసం కొనుగోలుదారు సమీక్షలను తనిఖీ చేయండి. మీ అవసరాలను చర్చించడానికి నిపుణులకు సందేశం పంపండి.
పత్రాలు మరియు యాక్సెస్ను అందించండి మీ పత్రాల సేకరణను భాగస్వామ్యం చేయండి లేదా మీ కంటెంట్ ప్లాట్ఫారమ్లకు API యాక్సెస్ను అందించండి. నమూనా ప్రశ్నలు, మూల్యాంకనం కోసం ఆశించిన సమాధానాలు మరియు ఏదైనా డొమైన్-నిర్దిష్ట పదజాలాన్ని అందించండి. విభిన్న వినియోగదారులు విభిన్న కంటెంట్ను చూడాలంటే యాక్సెస్ నియంత్రణ అవసరాలను పేర్కొనండి.
మూల్యాంకనం చేయండి, అమలు చేయండి మరియు పర్యవేక్షించండి తిరిగి పొందే ఖచ్చితత్వం, సమాధానం యొక్క సరైనత మరియు భ్రాంతి రేట్లను చూపించే మూల్యాంకన ఫలితాలను సమీక్షించండి. నిజమైన వినియోగదారులు మరియు అంచు కేసులతో పరీక్షించండి. ఖచ్చితత్వం, వినియోగం మరియు పనితీరును ట్రాక్ చేసే పర్యవేక్షణ డాష్బోర్డ్లతో అమలు చేయండి. పూర్తి ఆర్కిటెక్చర్ డాక్యుమెంటేషన్ మరియు నిర్వహణ విధానాలను స్వీకరించండి.
RAG & నాలెడ్జ్ బేస్ల గురించి తరచుగా అడిగే ప్రశ్నలు
Zinn Hubలో నేను ఏ RAG మరియు నాలెడ్జ్ బేస్ సేవలను కొనుగోలు చేయగలను?+
Zinn Hub అనుభవజ్ఞులైన AI ఇంజనీర్ల నుండి RAG మరియు నాలెడ్జ్ బేస్ డెవలప్మెంట్ సేవల పూర్తి శ్రేణిని అందిస్తుంది. మీరు కస్టమ్ RAG పైప్లైన్ డెవలప్మెంట్ను కొనుగోలు చేయవచ్చు — మీ పత్రాలు, డేటాబేస్లు మరియు నాలెడ్జ్ సోర్స్లను AI మోడల్లకు కనెక్ట్ చేసే ఎండ్-టు-ఎండ్ రిట్రీవల్ ఆగ్మెంటెడ్ జనరేషన్ సిస్టమ్లు, తద్వారా అవి మీ నిర్దిష్ట డేటాను ఉపయోగించి ప్రశ్నలకు ఖచ్చితంగా సమాధానం ఇస్తాయి. వెక్టర్ డేటాబేస్ సెటప్ మరియు కాన్ఫిగరేషన్ — Pinecone, Weaviate, Qdrant, Milvus, ChromaDB లేదా pgvector ఇన్స్టాలేషన్, స్కీమా డిజైన్, ఇండెక్సింగ్ స్ట్రాటజీలు, మెటాడేటా ఫిల్టరింగ్ మరియు క్వెరీ ఆప్టిమైజేషన్. డాక్యుమెంట్ ఇన్జెషన్ పైప్లైన్లు — PDFలు, వర్డ్ డాక్యుమెంట్లు, స్ప్రెడ్షీట్లు, వెబ్ పేజీలు, కాన్ఫ్లూయెన్స్ వికీలు, నోషన్ డేటాబేస్లు, షేర్పాయింట్ లైబ్రరీలు మరియు ఇతర మూలాలను చంక్డ్, ఎంబెడెడ్, ఇండెక్స్ చేయబడిన కంటెంట్గా ప్రాసెస్ చేయడం, రిట్రీవల్ కోసం సిద్ధంగా ఉంది. AI-శక్తితో కూడిన డాక్యుమెంట్ Q&A సిస్టమ్లు — చాట్బాట్ లేదా శోధన ఇంటర్ఫేస్లు, ఇక్కడ వినియోగదారులు సహజ భాషా ప్రశ్నలను అడుగుతారు మరియు మీ డాక్యుమెంటేషన్ నుండి నేరుగా ఉల్లేఖనాలతో ఖచ్చితమైన సమాధానాలను పొందుతారు. నాలెడ్జ్ బేస్ చాట్బాట్లు — మీ నాలెడ్జ్ బేస్, ఉత్పత్తి డాక్యుమెంటేషన్, సహాయ కేంద్ర కథనాలు, SOPలు లేదా పాలసీ డాక్యుమెంట్ల నుండి ప్రశ్నలకు సమాధానం ఇచ్చే కస్టమర్-ఫేసింగ్ లేదా అంతర్గత AI అసిస్టెంట్లు. హైబ్రిడ్ శోధన అమలు — BM25ని ఉపయోగించి వెక్టర్ సారూప్యత శోధనను సాంప్రదాయ కీవర్డ్ శోధనతో కలపడం, ఇది సెమాంటిక్ అర్థం మరియు ఖచ్చితమైన పదజాలం రెండింటినీ నిర్వహించే రిట్రీవల్ కోసం. చంకింగ్ స్ట్రాటజీ ఆప్టిమైజేషన్ — మీ కంటెంట్ రకం కోసం సరైన డాక్యుమెంట్ స్ప్లిటింగ్ విధానాన్ని పరీక్షించడం మరియు అమలు చేయడం, సరైన రిట్రీవల్ ఖచ్చితత్వం కోసం చంక్ పరిమాణం, అతివ్యాప్తి మరియు మెటాడేటా సంరక్షణను సమతుల్యం చేయడం. ఎంబెడింగ్ మోడల్ ఎంపిక మరియు ఫైన్-ట్యూనింగ్ — మీ డొమైన్ మరియు కంటెంట్ రకం కోసం సరైన ఎంబెడింగ్ మోడల్ను ఎంచుకోవడం, ప్రత్యామ్నాయాలను బెంచ్మార్క్ చేయడం మరియు మెరుగైన రిట్రీవల్ ప్రాసంగికత కోసం మీ డేటాపై ఎంబెడింగ్లను ఐచ్ఛికంగా ఫైన్-ట్యూన్ చేయడం. మల్టీ-మోడల్ RAG సిస్టమ్లు — టెక్స్ట్తో పాటు చిత్రాలు, రేఖాచిత్రాలు, పట్టికలు మరియు చార్ట్లపై రిట్రీవల్, మీ పత్రాలలో దృశ్యమాన కంటెంట్ గురించి ప్రశ్నలకు సమాధానం ఇవ్వడానికి AIని అనుమతిస్తుంది. మరియు RAG మూల్యాంకనం మరియు పర్యవేక్షణ — రిట్రీవల్ ఖచ్చితత్వం, సమాధానం సరైనది, భ్రాంతి రేట్లు మరియు స్వయంచాలక స్కోరింగ్తో ప్రతిస్పందన నాణ్యతను కొలిచే మూల్యాంకన పైప్లైన్లను నిర్మించడం.
Zinn Hubలో RAG మరియు నాలెడ్జ్ బేస్ సేవల ధర ఎంత?+
ఖర్చులు RAG ఆర్కిటెక్చర్ యొక్క సంక్లిష్టత, మూల పత్రాల పరిమాణం మరియు వైవిధ్యం, మరియు అవసరమైన ఖచ్చితత్వ స్థాయిపై ఆధారపడి ఉంటాయి. ఒక సాధారణ చాట్ ఇంటర్ఫేస్తో 500 పేజీల వరకు ఒకే డాక్యుమెంట్ సేకరణను స్వీకరించే ప్రాథమిక RAG సిస్టమ్ $500-1500 ఖర్చవుతుంది. బహుళ డాక్యుమెంట్ మూలాలు, హైబ్రిడ్ శోధన, మెటాడేటా ఫిల్టరింగ్, ఉల్లేఖన ఉత్పత్తి మరియు మెరుగుపెట్టిన చాట్ UIతో కూడిన ఉత్పత్తి RAG పైప్లైన్ $1500-5000 ఖర్చవుతుంది. స్కీమా డిజైన్, ఇండెక్సింగ్ ఆప్టిమైజేషన్ మరియు క్వెరీ ట్యూనింగ్తో వెక్టర్ డేటాబేస్ సెటప్ మరియు కాన్ఫిగరేషన్ $300-1000 ఖర్చవుతుంది. Confluence, Notion, SharePoint లేదా ఇతర ప్లాట్ఫారమ్ల నుండి కంటెంట్ను ఆటోమేటెడ్ సింకింగ్తో ప్రాసెస్ చేసే డాక్యుమెంట్ ఇన్జెషన్ పైప్లైన్ $500-2000 ఖర్చవుతుంది. బ్రాండెడ్ ఇంటర్ఫేస్, సంభాషణ చరిత్ర, అభిప్రాయ సేకరణ మరియు విశ్లేషణలతో కూడిన కస్టమర్-ఫేసింగ్ నాలెడ్జ్ బేస్ చాట్బాట్ $1000-4000 ఖర్చవుతుంది. వెక్టర్ మరియు కీవర్డ్ శోధనను సంబంధిత ట్యూనింగ్తో కలిపి హైబ్రిడ్ శోధన అమలు $500-1500 ఖర్చవుతుంది. బహుళ విధానాలలో క్రమబద్ధమైన పరీక్ష మరియు పరిమాణాత్మక ఖచ్చితత్వ పోలికలతో చంకింగ్ వ్యూహం ఆప్టిమైజేషన్ $300-1000 ఖర్చవుతుంది. మీ నిర్దిష్ట కంటెంట్ డొమైన్ కోసం ఎంబెడింగ్ మోడల్ బెంచ్మార్కింగ్ మరియు ఎంపిక $300-800 ఖర్చవుతుంది. బహుళ డేటా మూలాలు, పాత్ర-ఆధారిత యాక్సెస్ నియంత్రణలు, ఆడిట్ లాగింగ్, మూల్యాంకన పైప్లైన్లు మరియు కొనసాగుతున్న పర్యవేక్షణతో కూడిన సమగ్ర ఎంటర్ప్రైజ్ RAG సిస్టమ్ $3000-10000 ఖర్చవుతుంది. రీ-ఇండెక్సింగ్, ఖచ్చితత్వ పర్యవేక్షణ, ప్రాంప్ట్ అప్డేట్లు మరియు సోర్స్ సింకింగ్తో సహా కొనసాగుతున్న నెలవారీ నిర్వహణ సాధారణంగా నెలకు $200-800 వరకు ఉంటుంది.
RAG అంటే ఏమిటి మరియు అది ఎలా పనిచేస్తుంది?+
RAG — రిట్రీవల్ ఆగ్మెంటెడ్ జనరేషన్ — అనేది AI భాషా మోడల్లను మీ నిర్దిష్ట డేటాకు కనెక్ట్ చేసే ఒక ఆర్కిటెక్చర్, తద్వారా అవి తమ శిక్షణ డేటాపై మాత్రమే ఆధారపడకుండా మీ పత్రాలు, డేటాబేస్లు మరియు జ్ఞాన వనరుల నుండి సమాచారాన్ని ఉపయోగించి ప్రశ్నలకు ఖచ్చితంగా సమాధానం ఇవ్వగలవు. RAG లేకుండా, AI మోడల్లు శిక్షణ సమయంలో నేర్చుకున్న వాటి ఆధారంగా మాత్రమే ప్రతిస్పందించగలవు — అవి మీ అంతర్గత డాక్యుమెంటేషన్, ఉత్పత్తి లక్షణాలు, కంపెనీ విధానాలు, కస్టమర్ డేటా లేదా వాటి శిక్షణ సమితిలో లేని ఏ సమాచారాన్ని యాక్సెస్ చేయలేవు. RAG జనరేషన్కు ముందు రిట్రీవల్ దశను జోడించడం ద్వారా దీనిని పరిష్కరిస్తుంది. ఈ ప్రక్రియ మూడు దశల్లో పనిచేస్తుంది. మొదట, మీ పత్రాలు ఇన్జెషన్ దశలో ప్రాసెస్ చేయబడతాయి — అవి ముక్కలుగా విభజించబడతాయి, ప్రతి ముక్క ఎంబెడింగ్ మోడల్ను ఉపయోగించి ఎంబెడింగ్ అని పిలువబడే సంఖ్యా ప్రాతినిధ్యంగా మార్చబడుతుంది మరియు ఈ ఎంబెడింగ్లు అసలు వచనం మరియు మెటాడేటాతో పాటు వెక్టర్ డేటాబేస్లో నిల్వ చేయబడతాయి. రెండవది, ఒక వినియోగదారు ప్రశ్న అడిగినప్పుడు, ప్రశ్న కూడా ఎంబెడింగ్గా మార్చబడుతుంది మరియు ప్రశ్న ఎంబెడింగ్కు అత్యంత సారూప్యమైన ముక్కల కోసం వెక్టర్ డేటాబేస్ శోధించబడుతుంది — ఇది సెమాంటిక్ శోధన, కీవర్డ్ సరిపోలిక కాకుండా అర్థం ద్వారా కంటెంట్ను కనుగొనడం. మూడవది, అత్యంత సంబంధిత ముక్కలు తిరిగి పొందబడతాయి మరియు వినియోగదారు ప్రశ్నతో పాటు సందర్భం వలె AI మోడల్కు పంపబడతాయి మరియు మోడల్ తిరిగి పొందిన కంటెంట్ ఆధారంగా సమాధానాన్ని ఉత్పత్తి చేస్తుంది. ఫలితం ఏమిటంటే, మీ నిర్దిష్ట డేటాను ఉపయోగించి ప్రశ్నలకు ఖచ్చితంగా సమాధానం ఇచ్చే, దాని మూలాలను ఉదహరించగల, మీ పత్రాలు నవీకరించబడినప్పుడు ప్రస్తుత స్థితిలో ఉండే మరియు జ్ఞాపకశక్తి నుండి కాకుండా తిరిగి పొందిన సాక్ష్యం నుండి ఉత్పత్తి చేస్తున్నందున సమాచారాన్ని భ్రమపడని AI సిస్టమ్.
వెక్టర్ డేటాబేస్ అంటే ఏమిటి మరియు RAG కోసం నాకు అది ఎందుకు అవసరం?+
ఒక వెక్టర్ డేటాబేస్ అనేది అధిక-డైమెన్షనల్ సంఖ్యా వెక్టర్లను నిల్వ చేయడానికి మరియు శోధించడానికి రూపొందించబడిన ఒక ప్రత్యేక డేటాబేస్ — ఎంబెడింగ్ మోడల్ల ద్వారా సృష్టించబడిన టెక్స్ట్, చిత్రాలు లేదా ఇతర కంటెంట్ యొక్క గణిత ప్రాతినిధ్యాలు. సాంప్రదాయ డేటాబేస్లు ఖచ్చితమైన సరిపోలికలు లేదా కీలకపద నమూనాల ద్వారా శోధిస్తాయి. వెక్టర్ డేటాబేస్లు సారూప్యత ద్వారా శోధిస్తాయి — ఒక ప్రశ్న వెక్టర్ ఇవ్వబడినప్పుడు, అవి అర్థంలో దగ్గరగా ఉన్న నిల్వ చేయబడిన వెక్టర్లను కనుగొంటాయి, అవి పూర్తిగా భిన్నమైన పదాలను ఉపయోగించినప్పటికీ. RAG కోసం మీకు వెక్టర్ డేటాబేస్ అవసరం ఎందుకంటే సెమాంటిక్ శోధన అనేది తిరిగి పొందడాన్ని పని చేసే ప్రధాన యంత్రాంగం. ఒక వినియోగదారు మీ డాక్యుమెంటేషన్ గురించి ఒక ప్రశ్న అడిగినప్పుడు, సిస్టమ్ అత్యంత సంబంధిత భాగాలను కనుగొనాలి — కీలకపదాలను సరిపోల్చడం ద్వారా కాదు, అర్థాన్ని అర్థం చేసుకోవడం ద్వారా. రిటర్న్ పాలసీల గురించి ఒక ప్రశ్న మీ రిటర్న్స్ డాక్యుమెంటేషన్ను కనుగొనాలి, ప్రశ్నలో "రిటర్న్" అనే ఖచ్చితమైన పదం కనిపించకపోయినా. వెక్టర్ డేటాబేస్లు ఈ సారూప్యత శోధనను వేగంగా మరియు స్కేలబుల్గా చేస్తాయి, మిలియన్ల కొద్దీ డాక్యుమెంట్ ముక్కలలో కూడా. ప్రసిద్ధ వెక్టర్ డేటాబేస్లలో Pinecone ఉంది, ఇది సాధారణ API యాక్సెస్ మరియు ఆటోమేటిక్ స్కేలింగ్తో పూర్తిగా నిర్వహించబడే క్లౌడ్ సేవ. Weaviate అనేది ఓపెన్-సోర్స్, వెక్టర్ మరియు కీలకపదాల తిరిగి పొందడాన్ని కలిపి అంతర్నిర్మిత హైబ్రిడ్ శోధనతో. Qdrant అనేది బలమైన ఫిల్టరింగ్ సామర్థ్యాలు మరియు సమర్థవంతమైన మెమరీ వినియోగంతో ఓపెన్-సోర్స్. ChromaDB అనేది తేలికైనది మరియు డెవలపర్-స్నేహపూర్వకమైనది, ప్రోటోటైపింగ్ మరియు చిన్న విస్తరణలకు అనువైనది. Milvus అనేది ఓపెన్-సోర్స్ మరియు పెద్ద-స్థాయి ఎంటర్ప్రైజ్ విస్తరణల కోసం రూపొందించబడింది. మరియు pgvector అనేది మీ ప్రస్తుత PostgreSQL డేటాబేస్కు వెక్టర్ శోధనను జోడించే ఒక PostgreSQL పొడిగింపు, ప్రత్యేక సిస్టమ్ అవసరాన్ని నివారిస్తుంది. ఎంపిక స్కేల్, మౌలిక సదుపాయాల ప్రాధాన్యతలు, మీరు నిర్వహించబడిన లేదా స్వీయ-హోస్ట్ చేయబడిన వాటిని కోరుకుంటున్నారా మరియు మీకు హైబ్రిడ్ శోధన, బహుళ-అద్దె లేదా అధునాతన ఫిల్టరింగ్ వంటి లక్షణాలు అవసరమా అనే దానిపై ఆధారపడి ఉంటుంది.
RAG మరియు AI మోడల్ను ఫైన్-ట్యూన్ చేయడం మధ్య తేడా ఏమిటి?+
RAG మరియు ఫైన్-ట్యూనింగ్ వేర్వేరు సమస్యలను పరిష్కరిస్తాయి మరియు తరచుగా గందరగోళానికి గురవుతాయి. ఫైన్-ట్యూనింగ్ అదనపు డేటాపై శిక్షణ ఇవ్వడం ద్వారా AI మోడల్ను సవరించింది — మోడల్ శాశ్వతంగా కొత్త నమూనాలను, వ్రాత శైలులను లేదా డొమైన్ జ్ఞానాన్ని నేర్చుకుంటుంది. RAG మోడల్ను సవరించదు — ఇది బాహ్య జ్ఞాన స్థావరం నుండి ప్రశ్న సమయంలో సంబంధిత సందర్భాన్ని అందిస్తుంది మరియు మోడల్ ఆ సందర్భంలో ఆధారపడిన సమాధానాలను ఉత్పత్తి చేస్తుంది. మోడల్కు నిర్దిష్ట వ్రాత శైలి, స్వరం లేదా ఆకృతిని నేర్పడానికి ఫైన్-ట్యూనింగ్ ఉత్తమం. మోడల్లో డొమైన్-నిర్దిష్ట పదజాలం మరియు తార్కిక నమూనాలను పొందుపరచడానికి. మోడల్ బరువులలో సాధారణ సూచనలను ఎన్కోడ్ చేయడం ద్వారా ప్రాంప్ట్ పొడవును తగ్గించడానికి. మరియు అవసరమైన జ్ఞానం స్థిరంగా మరియు తరచుగా మారనటువంటి పనుల కోసం. పెద్ద, అభివృద్ధి చెందుతున్న డాక్యుమెంట్ సేకరణ నుండి ప్రశ్నలకు సమాధానం ఇవ్వడానికి RAG ఉత్తమం. మూల సమాచారం తరచుగా మారుతుంది మరియు ప్రస్తుతానికి ఉండాల్సిన పనుల కోసం. నిర్దిష్ట మూల పత్రాలకు గుర్తించదగిన, ధృవీకరించదగిన సమాధానాలను అందించడానికి. మోడల్ శిక్షణలో చేర్చకూడని యాజమాన్య లేదా సున్నితమైన డేటాతో పని చేయడానికి. మరియు శైలీకృత అనుసరణ కంటే ఖచ్చితత్వం మరియు ఆధారపడటం ముఖ్యమైన పనుల కోసం. ఆచరణలో, చాలా వ్యాపార జ్ఞాన స్థావరం మరియు డాక్యుమెంట్ Q&A అప్లికేషన్లకు RAG సరైన ఎంపిక, ఎందుకంటే సమాచారం కాలక్రమేణా మారుతుంది, వినియోగదారులు మూలాలకు వ్యతిరేకంగా సమాధానాలను ధృవీకరించాలి మరియు కంటెంట్ పరిమాణం మోడల్లో ఆర్థికంగా ఫైన్-ట్యూన్ చేయడానికి చాలా పెద్దది. రెండు విధానాలను కలపవచ్చు — తిరిగి పొందడం కోసం RAGని కూడా ఉపయోగించే ఫైన్-ట్యూన్డ్ మోడల్ — కానీ చాలా అమలులు RAGతో మాత్రమే ప్రారంభమవుతాయి, ఎందుకంటే ఇది మోడల్ శిక్షణ ఖర్చు మరియు సంక్లిష్టత లేకుండా తక్షణ విలువను అందిస్తుంది.
RAG సిస్టమ్లో నేను వివిధ డాక్యుమెంట్ రకాలను ఎలా నిర్వహించాలి?+
నిజ-ప్రపంచ విజ్ఞాన స్థావరాలు విభిన్న డాక్యుమెంట్ రకాలను కలిగి ఉంటాయి, ప్రతి ఒక్కటి విభిన్న ఇంజెషన్ విధానాలను కోరుతుంది. PDFలు అత్యంత సాధారణమైనవి మరియు అత్యంత సవాలుతో కూడుకున్నవి — అవి టెక్స్ట్, పట్టికలు, చిత్రాలు, హెడర్లు, ఫుటర్లు, బహుళ-నిలువు వరుస లేఅవుట్లు మరియు స్కాన్ చేసిన పేజీలను కలిగి ఉంటాయి. టెక్స్ట్-ఆధారిత PDFలు PyMuPDF, pdfplumber లేదా Unstructured వంటి లైబ్రరీలతో పార్స్ చేయబడతాయి, పట్టికలు మరియు బహుళ-నిలువు వరుస లేఅవుట్ల కోసం ప్రత్యేక నిర్వహణ అవసరం. స్కాన్ చేసిన PDFలకు టెక్స్ట్ చంక్ చేయబడి మరియు ఎంబెడ్ చేయబడటానికి ముందు Tesseract లేదా క్లౌడ్ OCR సేవలు వంటి సాధనాలతో OCR అవసరం. వర్డ్ డాక్యుమెంట్లు python-docx లేదా ఇలాంటి లైబ్రరీలతో పార్స్ చేయబడతాయి, డాక్యుమెంట్ సోపానక్రమాన్ని గౌరవించే తెలివైన చంకింగ్ కోసం హెడ్డింగ్ నిర్మాణాన్ని సంరక్షిస్తాయి. స్ప్రెడ్షీట్లకు అడ్డు వరుసలు లేదా విభాగాలను సహజ భాషా వివరణలు లేదా ఎంబెడింగ్ మోడల్లు అర్థవంతంగా ప్రాసెస్ చేయగల నిర్మాణాత్మక టెక్స్ట్ ప్రాతినిధ్యాలుగా మార్చడం అవసరం. వెబ్ పేజీలు స్క్రాప్ చేయబడతాయి మరియు నావిగేషన్, ప్రకటనలు మరియు బాయిలర్ప్లేట్ను తొలగిస్తూ ప్రధాన కంటెంట్ను సంగ్రహించడానికి శుభ్రం చేయబడతాయి. కాన్ఫ్లూయెన్స్, నోషన్ మరియు షేర్పాయింట్ కంటెంట్ వాటి సంబంధిత APIల ద్వారా యాక్సెస్ చేయబడుతుంది, పేజీ నిర్మాణం మరియు మెటాడేటా సంరక్షించబడుతుంది. కోడ్ రిపోజిటరీలకు ఫంక్షన్ మరియు క్లాస్ సరిహద్దులను గౌరవించే ప్రత్యేక చంకింగ్ అవసరం. మార్క్డౌన్ మరియు సాదా టెక్స్ట్ ఫైల్లు ప్రాసెస్ చేయడానికి సరళమైనవి కానీ ఇప్పటికీ నిర్మాణం-అవగాహన చంకింగ్ నుండి ప్రయోజనం పొందుతాయి. కీలక సూత్రం ఏమిటంటే, ప్రతి డాక్యుమెంట్ రకానికి అనుకూలీకరించిన పార్సింగ్ మరియు చంకింగ్ వ్యూహం అవసరం — శుభ్రమైన టెక్స్ట్ డాక్యుమెంట్లకు బాగా పనిచేసే పైప్లైన్ పట్టికలు మరియు రేఖాచిత్రాలతో కూడిన సంక్లిష్ట PDFలపై పేలవమైన ఫలితాలను ఉత్పత్తి చేస్తుంది. బలమైన RAG సిస్టమ్ డాక్యుమెంట్ రకం గుర్తింపు, ప్రతి రకానికి ప్రత్యేక పార్సర్లు మరియు పాడైపోయిన కంటెంట్ సూచికలోకి ప్రవేశించే ముందు పార్సింగ్ వైఫల్యాలను ఫ్లాగ్ చేసే నాణ్యత తనిఖీలను కలిగి ఉంటుంది.
చంకింగ్ అంటే ఏమిటి మరియు చంక్ పరిమాణం ఎందుకు ముఖ్యం?+
చంకింగ్ అనేది మీ డాక్యుమెంట్లను చిన్న ముక్కలుగా విభజించే ప్రక్రియ, అవి వ్యక్తిగతంగా ఎంబెడ్ చేయబడి వెక్టర్ డేటాబేస్లో నిల్వ చేయబడతాయి. వినియోగదారు ప్రశ్న అడిగినప్పుడు, సిస్టమ్ అత్యంత సంబంధిత చంక్లను — మొత్తం డాక్యుమెంట్లను కాదు — తిరిగి పొందుతుంది, కాబట్టి చంక్ పరిమాణం తిరిగి పొందే ఖచ్చితత్వం మరియు సమాధానం నాణ్యత రెండింటినీ నేరుగా ప్రభావితం చేస్తుంది. చంక్లు చాలా పెద్దవిగా ఉంటే, అవి చాలా సమాచారాన్ని కలిగి ఉంటాయి మరియు సంబంధిత వాక్యాలు చుట్టుపక్కల కంటెంట్ ద్వారా పలుచన చేయబడతాయి. ఎంబెడింగ్ మొత్తం చంక్ యొక్క సగటు అర్థాన్ని సూచిస్తుంది, కాబట్టి బహుళ అంశాల గురించి పెద్ద చంక్ ఆ అంశాలలో ఒకదాని గురించి నిర్దిష్ట ప్రశ్నకు సరిపోలదు. తిరిగి పొందిన పెద్ద చంక్లు AI మోడల్ యొక్క కాంటెక్స్ట్ విండోలో ఎక్కువ భాగాన్ని వినియోగిస్తాయి, బహుళ మూలాధారాలకు మరియు జనరేషన్ ప్రాంప్ట్కు తక్కువ స్థలాన్ని వదిలివేస్తాయి. చంక్లు చాలా చిన్నవిగా ఉంటే, అవి సందర్భాన్ని కోల్పోతాయి — ఒకే వాక్యం మోడల్ ఉపయోగకరమైన సమాధానాన్ని రూపొందించడానికి తగినంత సమాచారాన్ని కలిగి ఉండకపోవచ్చు మరియు చుట్టుపక్కల వాక్యాల నుండి ముఖ్యమైన సందర్భం కోల్పోతుంది. చాలా చిన్న చంక్లు డేటాబేస్లోని వెక్టర్ల సంఖ్యను మరియు ఒక అంశాన్ని కవర్ చేయడానికి అవసరమైన తిరిగి పొందే ఫలితాల సంఖ్యను కూడా పెంచుతాయి. సరైన చంక్ పరిమాణం మీ కంటెంట్ రకం మరియు ప్రశ్న నమూనాలపై ఆధారపడి ఉంటుంది. సహాయ కథనాలు మరియు ఉత్పత్తి గైడ్ల వంటి వాస్తవ డాక్యుమెంటేషన్ కోసం, 200-500 టోకెన్ల చంక్లు బాగా పనిచేస్తాయి ఎందుకంటే సమాచారం కేంద్రీకృతమై ఉంటుంది. నివేదికలు మరియు విశ్లేషణల వంటి కథన కంటెంట్ కోసం, 500-1000 టోకెన్ల పెద్ద చంక్లు తార్కిక ప్రవాహాన్ని సంరక్షిస్తాయి. చంక్ల మధ్య అతివ్యాప్తి — సాధారణంగా చంక్ సరిహద్దుల వద్ద 50-100 టోకెన్ల భాగస్వామ్య కంటెంట్ — చంక్ సరిహద్దుల అంతటా విభజించబడిన సమాచారం ఇప్పటికీ తిరిగి పొందగలిగేలా నిర్ధారిస్తుంది. మరింత అధునాతన విధానాలలో సహజ అంశ సరిహద్దుల వద్ద విభజించే సెమాంటిక్ చంకింగ్, క్రమానుగత ప్రాతినిధ్యాలను సృష్టించే రికర్సివ్ చంకింగ్ మరియు చిన్న చంక్లను తిరిగి పొందే పేరెంట్-చైల్డ్ చంకింగ్ ఉన్నాయి, అయితే పెద్ద పేరెంట్ చంక్లు మరింత సందర్భం కోసం మోడల్కు పంపబడతాయి.
RAG సిస్టమ్లో భ్రమలను ఎలా తగ్గించాలి?+
RAG సిస్టమ్స్లో భ్రాంతి అనేది AI మోడల్ తిరిగి పొందిన సందర్భంలో లేని సమాచారాన్ని ఉత్పత్తి చేసినప్పుడు సంభవిస్తుంది — వాస్తవాలను కల్పించడం, మూల కంటెంట్ను తప్పుగా సూచించడం లేదా తిరిగి పొందిన సమాచారాన్ని దాని స్వంత శిక్షణ జ్ఞానంతో తప్పుదారి పట్టించే విధంగా కలపడం. అనేక పద్ధతులు భ్రాంతిని క్రమపద్ధతిలో తగ్గిస్తాయి. ముందుగా తిరిగి పొందే ఖచ్చితత్వాన్ని మెరుగుపరచండి — భ్రాంతికి అత్యంత సాధారణ కారణం మోడల్ కాదు, పేలవమైన తిరిగి పొందడం. సరైన మూల పత్రాలు తిరిగి పొందకపోతే, మోడల్ అది సమాధానం చెప్పలేదని అంగీకరిస్తుంది, ఇది కావలసిన ప్రవర్తన, లేదా దాని శిక్షణ డేటా నుండి సమాధానాన్ని ఉత్పత్తి చేస్తుంది, ఇది భ్రాంతి. మెరుగైన చంకింగ్, హైబ్రిడ్ శోధన, మెటాడేటా ఫిల్టరింగ్ మరియు ఎంబెడింగ్ మోడల్ ఎంపిక అన్నీ తిరిగి పొందే ఖచ్చితత్వాన్ని మెరుగుపరుస్తాయి. మీ సిస్టమ్ ప్రాంప్ట్లో స్పష్టమైన గ్రౌండింగ్ సూచనలను ఉపయోగించండి — అందించిన సందర్భం నుండి మాత్రమే సమాధానం ఇవ్వమని మోడల్కు సూచించండి, సందర్భంలో సమాధానం లేనప్పుడు తనకు తెలియదని చెప్పమని మరియు దాని శిక్షణ డేటా నుండి సమాచారంతో ఎప్పుడూ భర్తీ చేయవద్దని సూచించండి. ఉదహరణ అవసరాలను చేర్చండి — ప్రతి వాదనకు నిర్దిష్ట మూలం మరియు విభాగాన్ని ఉదహరించమని మోడల్కు సూచించండి, ఇది ప్రతి ప్రకటనను తిరిగి పొందిన కంటెంట్లో గ్రౌండ్ చేయడానికి బలవంతం చేస్తుంది మరియు కల్పిత వాదనలను స్పష్టంగా చేస్తుంది. సమాధాన ధృవీకరణను అమలు చేయండి — ఉత్పత్తి చేయబడిన సమాధానం నిజంగా తిరిగి పొందిన సందర్భం ద్వారా మద్దతు ఇవ్వబడిందో లేదో తనిఖీ చేయడానికి రెండవ AI కాల్ను ఉపయోగించండి, మూల పదార్థానికి వాదనలను గుర్తించలేని ప్రతిస్పందనలను ఫ్లాగ్ చేయడం లేదా ఫిల్టర్ చేయడం. విశ్వసనీయత స్కోరింగ్ను జోడించండి — అందించిన సందర్భం ద్వారా సమాధానం పూర్తిగా మద్దతు ఇవ్వబడిందని దాని విశ్వసనీయతను రేట్ చేయమని మోడల్ను ప్రాంప్ట్ చేయండి. తిరిగి పొందే స్కోర్ థ్రెషోల్డ్లను ఉపయోగించండి — తిరిగి పొందిన చంక్ల సారూప్యత స్కోర్లు థ్రెషోల్డ్ కంటే తక్కువగా ఉంటే, బలహీనమైన సందర్భం నుండి సమాధానం ఇవ్వడానికి ప్రయత్నించకుండా తగినంత సమాచారం లేదని సూచించే ప్రతిస్పందనను తిరిగి ఇవ్వండి. మరియు తెలిసిన సమాధానాలతో పరీక్ష ప్రశ్నలలో భ్రాంతి రేట్లను నిరంతరం కొలిచే మూల్యాంకన పైప్లైన్లను నిర్మించండి.
నా పత్రాలు మారినప్పుడు ప్రస్తుతానికి ఉండే RAG సిస్టమ్ను నేను నిర్మించగలనా?+
అవును — ఒక ప్రొడక్షన్ RAG సిస్టమ్కు డాక్యుమెంట్ మార్పులను గుర్తించి, వెక్టర్ ఇండెక్స్ను తదనుగుణంగా అప్డేట్ చేసే ఆటోమేటెడ్ పైప్లైన్ అవసరం. ఇది డెమో RAG సిస్టమ్కు మరియు ప్రొడక్షన్ సిస్టమ్కు మధ్య ఉన్న కీలక వ్యత్యాసాలలో ఒకటి. విధానం మీ డాక్యుమెంట్ మూలాలపై ఆధారపడి ఉంటుంది. Confluence, Notion, SharePoint లేదా Google Drive వంటి క్లౌడ్ ప్లాట్ఫారమ్లలో నిల్వ చేయబడిన డాక్యుమెంట్ల కోసం, ఇన్జెషన్ పైప్లైన్ ప్లాట్ఫారమ్ APIని ఉపయోగించి కొత్త, సవరించిన మరియు తొలగించబడిన పేజీలను షెడ్యూల్లో గుర్తిస్తుంది — సాధారణంగా మీ కంటెంట్ ఎంత తరచుగా మారుతుందనే దానిపై ఆధారపడి గంటకు లేదా రోజువారీగా. కొత్త పేజీలు ముక్కలు చేయబడతాయి, పొందుపరచబడతాయి మరియు వెక్టర్ ఇండెక్స్కు జోడించబడతాయి. సవరించిన పేజీల పాత ముక్కలు తొలగించబడతాయి మరియు కొత్త ముక్కలు చొప్పించబడతాయి. తొలగించబడిన పేజీల ముక్కలు ఇండెక్స్ నుండి తీసివేయబడతాయి. ఫైల్-ఆధారిత డాక్యుమెంట్ స్టోర్ల కోసం, పైప్లైన్ చెక్సమ్లు లేదా సవరణ టైమ్స్టాంప్లను ఉపయోగించి ఫైల్ మార్పుల కోసం డైరెక్టరీలను పర్యవేక్షిస్తుంది. వెబ్ కంటెంట్ కోసం, పైప్లైన్ షెడ్యూల్లో సోర్స్ URLలను తిరిగి క్రాల్ చేస్తుంది మరియు మార్పులను గుర్తించడానికి కంటెంట్ హాష్లను పోల్చుతుంది. కీలకమైన నిర్మాణ నిర్ణయాలు సింక్ ఫ్రీక్వెన్సీ — పైప్లైన్ మార్పుల కోసం ఎంత తరచుగా తనిఖీ చేస్తుంది — మరియు మార్పు గుర్తింపు యొక్క గ్రాన్యులారిటీ — మీరు మొత్తం డాక్యుమెంట్లను తిరిగి ప్రాసెస్ చేస్తారా లేదా మార్చబడిన విభాగాలను మాత్రమే చేస్తారా. మార్చబడిన కంటెంట్ను మాత్రమే తిరిగి పొందుపరిచే ఇంక్రిమెంటల్ ప్రాసెసింగ్ మరింత సమర్థవంతమైనది కానీ పూర్తి రీ-ఇన్జెషన్ కంటే అమలు చేయడానికి మరింత సంక్లిష్టమైనది. మీరు మెటాడేటా అప్డేట్లను కూడా నిర్వహించాలి — డాక్యుమెంట్ శీర్షిక, రచయిత లేదా వర్గం మారినప్పుడు, వెక్టర్ డేటాబేస్లోని అనుబంధిత ముక్క మెటాడేటా అప్డేట్ చేయబడాలి. Zinn Hubలోని నిపుణులు ప్రొడక్షన్ RAG డిప్లాయ్మెంట్లలో భాగంగా ఈ ఆటోమేటెడ్ సింక్ పైప్లైన్లను నిర్మిస్తారు, తద్వారా మీ నాలెడ్జ్ బేస్ మాన్యువల్ జోక్యం లేకుండా తాజాగా ఉంటుంది.
Zinn Hubలో RAG మరియు నాలెడ్జ్ బేస్ స్పెషలిస్ట్ను నేను ఎలా ఎంచుకోవాలి?+
Zinn Hubలో RAG మరియు నాలెడ్జ్ బేస్ స్పెషలిస్ట్ను ఎంచుకునేటప్పుడు, ఎండ్-టు-ఎండ్ RAG సిస్టమ్లను నిర్మించడంలో నిరూపితమైన అనుభవాన్ని చూడండి — కేవలం ప్రాంప్ట్ ఇంజనీరింగ్ లేదా చాట్బాట్ ఇంటర్ఫేస్లు కాదు. RAGలో డాక్యుమెంట్ ప్రాసెసింగ్, ఎంబెడింగ్ మోడల్స్, వెక్టర్ డేటాబేస్లు, రిట్రీవల్ అల్గారిథమ్లు, ప్రాంప్ట్ ఇంజనీరింగ్ మరియు మూల్యాంకనం వంటి బహుళ సాంకేతిక డొమైన్లు ఉంటాయి మరియు స్పెషలిస్ట్కు వాటి అన్నింటిలో లోతైన జ్ఞానం అవసరం. మీ డాక్యుమెంట్ రకాలు మరియు వాల్యూమ్లకు సమానమైన RAG ప్రాజెక్ట్ల కోసం వారి పోర్ట్ఫోలియోను సమీక్షించండి. మీకు పట్టికలు మరియు చిత్రాలతో కూడిన సంక్లిష్ట PDFలు ఉంటే, వారికి ఆ నిర్దిష్ట పార్సింగ్ సవాళ్లతో అనుభవం ఉందని నిర్ధారించండి. మీకు కాన్ఫ్లూయెన్స్, షేర్పాయింట్ లేదా డేటాబేస్ల నుండి బహుళ-మూల ఇన్జెషన్ అవసరమైతే, ఆ నిర్దిష్ట ఇంటిగ్రేషన్లతో అనుభవం కోసం తనిఖీ చేయండి. సమాధానం ఖచ్చితత్వం, రిట్రీవల్ నాణ్యత, సిస్టమ్ విశ్వసనీయత మరియు డాక్యుమెంటేషన్పై అభిప్రాయం కోసం కొనుగోలుదారు సమీక్షలను చదవండి. వారి చంకింగ్ మరియు ఎంబెడింగ్ విధానం గురించి అడగండి — ఒక మంచి స్పెషలిస్ట్ చంకింగ్ వ్యూహాల మధ్య ట్రేడ్-ఆఫ్లను చర్చిస్తారు మరియు ఒకే-పరిమాణం-అన్నింటికీ సరిపోయే పద్ధతిని ఉపయోగించకుండా మీ కంటెంట్ రకం ఆధారంగా ఒక విధానాన్ని సిఫార్సు చేస్తారు. వారు నాణ్యతను ఎలా కొలుస్తారని అడగండి — వృత్తిపరమైన RAG ఇంజనీర్లు తెలిసిన ప్రశ్నలు మరియు ఆశించిన సమాధానాలతో మూల్యాంకన సెట్లను నిర్మిస్తారు మరియు రిట్రీవల్ ఖచ్చితత్వం, సమాధానం సరైనది మరియు భ్రమల రేట్లను పరిమాణాత్మకంగా కొలుస్తారు. భ్రమల నివారణకు వారి విధానం గురించి అడగండి — గ్రౌండింగ్ సూచనలు, ఉల్లేఖన జనరేషన్, విశ్వసనీయత స్కోరింగ్ మరియు ధృవీకరణ దశలు. వారి సిస్టమ్లో కొనసాగుతున్న నిర్వహణ కోసం ఏమి ఉంటుందని అడగండి — ఆటోమేటెడ్ రీ-ఇండెక్సింగ్, పర్యవేక్షణ డాష్బోర్డ్లు, ఖచ్చితత్వ ట్రాకింగ్ మరియు హెచ్చరిక కాన్ఫిగరేషన్లు. ఎంటర్ప్రైజ్ డిప్లాయ్మెంట్ల కోసం, యాక్సెస్ నియంత్రణలు, బహుళ-అద్దె, ఆడిట్ లాగింగ్ మరియు సమ్మతి అవసరాలతో అనుభవాన్ని నిర్ధారించండి. మీ డాక్యుమెంట్ మూలాలు, వాల్యూమ్, ప్రశ్న రకాలు మరియు ఖచ్చితత్వ అవసరాలను చర్చించడానికి ఆర్డర్ చేయడానికి ముందు నిపుణులకు సందేశం పంపండి.