

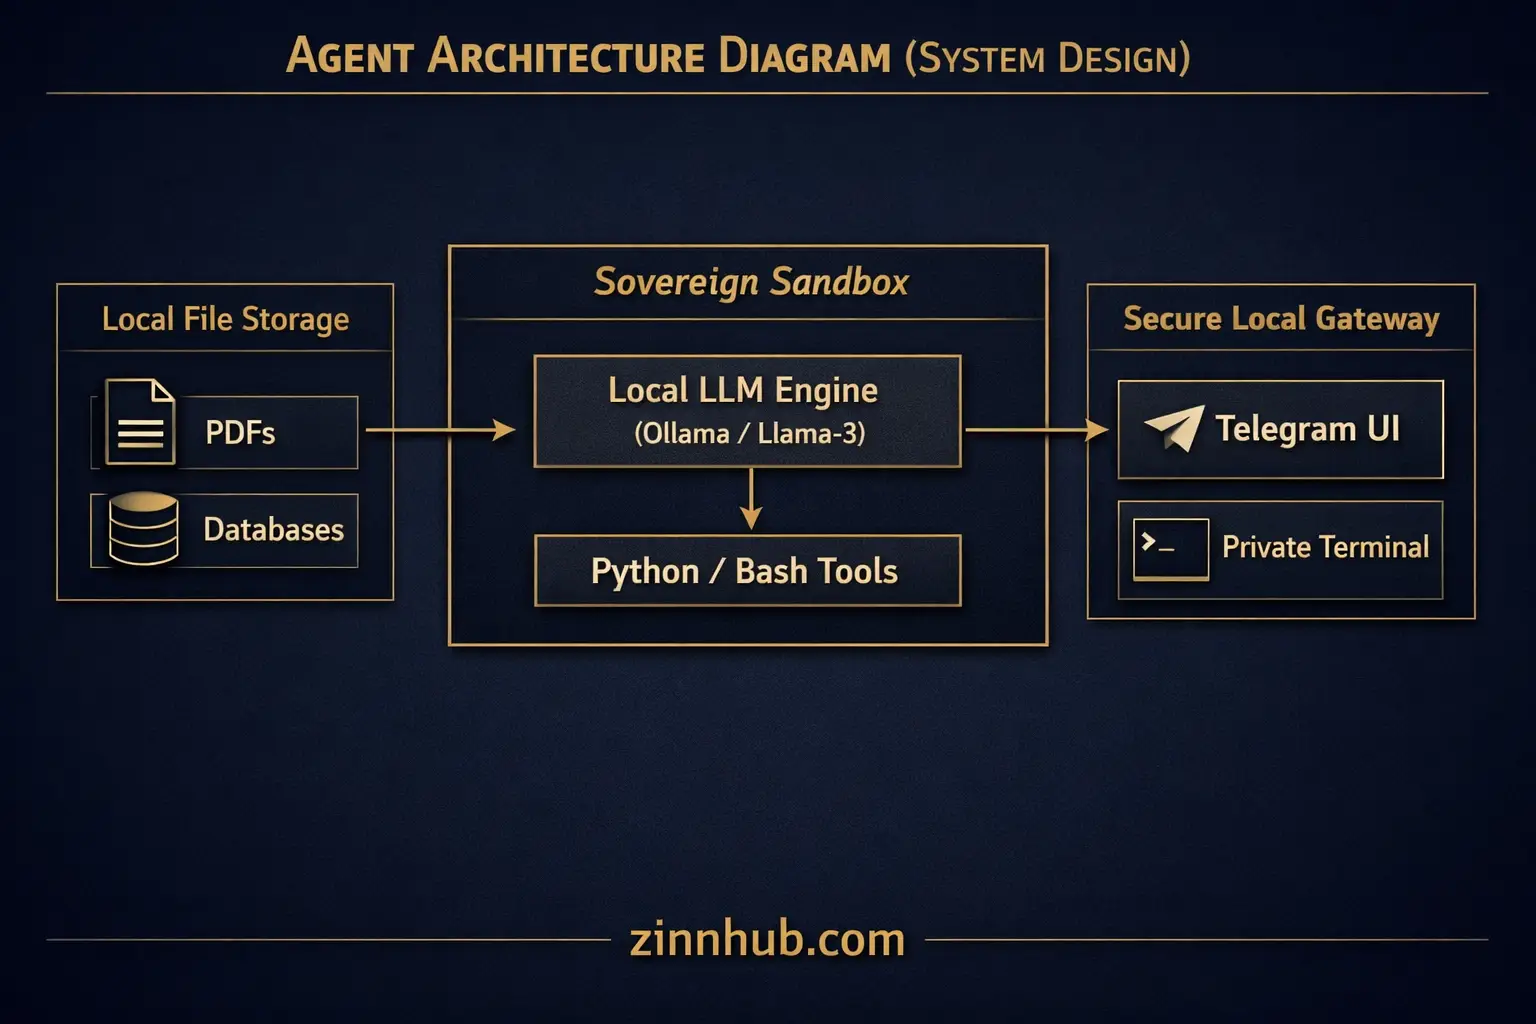
Uruchamianie lokalnych LLM i potoków RAG wymaga precyzyjnej równowagi zasobów sprzętowych. Jeśli parametry modelu przekraczają dostępną pamięć VRAM GPU lub pamięć RAM systemu, szybkość wykonywania spada niemal do zera, ponieważ system operacyjny jest zmuszony do korzystania z pamięci masowej systemu. To…
Przeprowadzę lokalny audyt kompatybilności sprzętu i modelu
Poproś o ofertę niestandardową
Zaloguj się, aby poprosić o ofertę niestandardową
Utwórz bezpłatne konto lub zaloguj się, aby poprosić o spersonalizowaną ofertę od tego Zinner.
Zaloguj się / Zarejestruj sięZadaj pytanie przed zakupem
Zaloguj się, aby zadać pytanie
Aby zmniejszyć spam na platformie, wiadomości przed sprzedażą mogą być wysyłane tylko przez zalogowanych użytkowników.
Utwórz bezpłatne konto lub zaloguj się, aby wysłać wiadomość do tego Zinner bezpośrednio.
Zaloguj się / Zarejestruj sięWymagane logowanie
Utwórz bezpłatne konto lub zaloguj się, aby wysłać wiadomość do tego Zinner.
Zaloguj się / Zarejestruj sięWymagane logowanie
Utwórz bezpłatne konto lub zaloguj się, aby poprosić o spersonalizowaną ofertę.
Zaloguj się / Zarejestruj sięAt a Glance
Kluczowe szczegóły dotyczące tej usługi, które pomogą Ci podjąć decyzję. Wygenerowane przez Zinn Hub, a nie przez sprzedawcę.
Pozycja Wartości
Co otrzymujesz
Szybki Czas Realizacji
Co musisz dostarczyć
Najlepsze dla
Pełny opis
Uruchamianie lokalnych modeli LLM i potoków RAG wymaga precyzyjnej równowagi zasobów sprzętowych. Jeśli parametry modelu przekraczają dostępną pamięć VRAM GPU lub RAM systemu, szybkość wykonania spada do prawie zera, ponieważ system operacyjny jest zmuszony do korzystania z pamięci masowej.
Ten Micro Zinn zapewnia kompletny audyt kompatybilności sprzętu przed zakupem lub instalacją jakiegokolwiek oprogramowania. Oceniamy Twój system fizyczny — niezależnie od tego, czy jest to Mac z Apple Silicon, stacja robocza NVIDIA CUDA, czy standardowy serwer Windows/Linux — aby powiedzieć Ci dokładnie, jak osiągnąć optymalną wydajność lokalną.
Co analizujemy:
1. Ograniczenia VRAM GPU: Mapujemy Twoją dedykowaną pamięć graficzną, aby znaleźć maksymalny pułap parametrów modelu (np. modele 7B, 13B lub 34B).
2. Alokacja pamięci RAM systemu: Określamy progi wnioskowania CPU i limity odciążania, jeśli brakuje Ci dedykowanego GPU lub działasz na współdzielonej pamięci systemowej.
3. Mapowanie kwantyzacji: Zalecamy dokładny poziom kwantyzacji (taki jak Q4_K_M, Q5_K_M lub Q8_0), aby zrównoważyć szybkość przetwarzania i inteligencję modelu.
4. Limity okna kontekstowego: Obliczamy bezpieczne maksymalne limity tokenów, aby zapobiec awariom systemu z powodu braku pamięci podczas intensywnego pobierania dokumentów.
Przestań zgadywać, które wagi open-source pobrać lub dlaczego Twoja lokalna konfiguracja jest wolna. Uzyskaj zaprojektowaną, sprzętowo-specyficzną mapę dla Twojego lokalnego środowiska AI od operatorów, którzy codziennie budują te systemy na fizycznym sprzęcie.
Przeprowadzono audyt kompatybilności sprzętowej, mapujący limity parametrów modelu Ollama, skale okien kontekstowych i optymalne kwantyzacje Q4/Q5 dla 128 GB RAM.
Wyświetl przykład ↗Micro Zinn to mała, stała cenowo usługa próbna lub mikro-usługa. CAVOK_Designs oferuje tę usługę za:
Prezentacja umiejętnościKreator portfolioOtwarty na nowych klientówGwarancja Jakości Zinner
Każdy Zinner jest sprawdzany i zatwierdzany przed dołączeniem do platformy.
Wszystkie usługi są objęte naszym zobowiązaniem do zapewnienia jakości.
Twoja płatność jest chroniona do momentu zatwierdzenia dostarczonej pracy.
Opinie klientów
Sprawdź, co nasi klienci mówią o tym Zinn

