

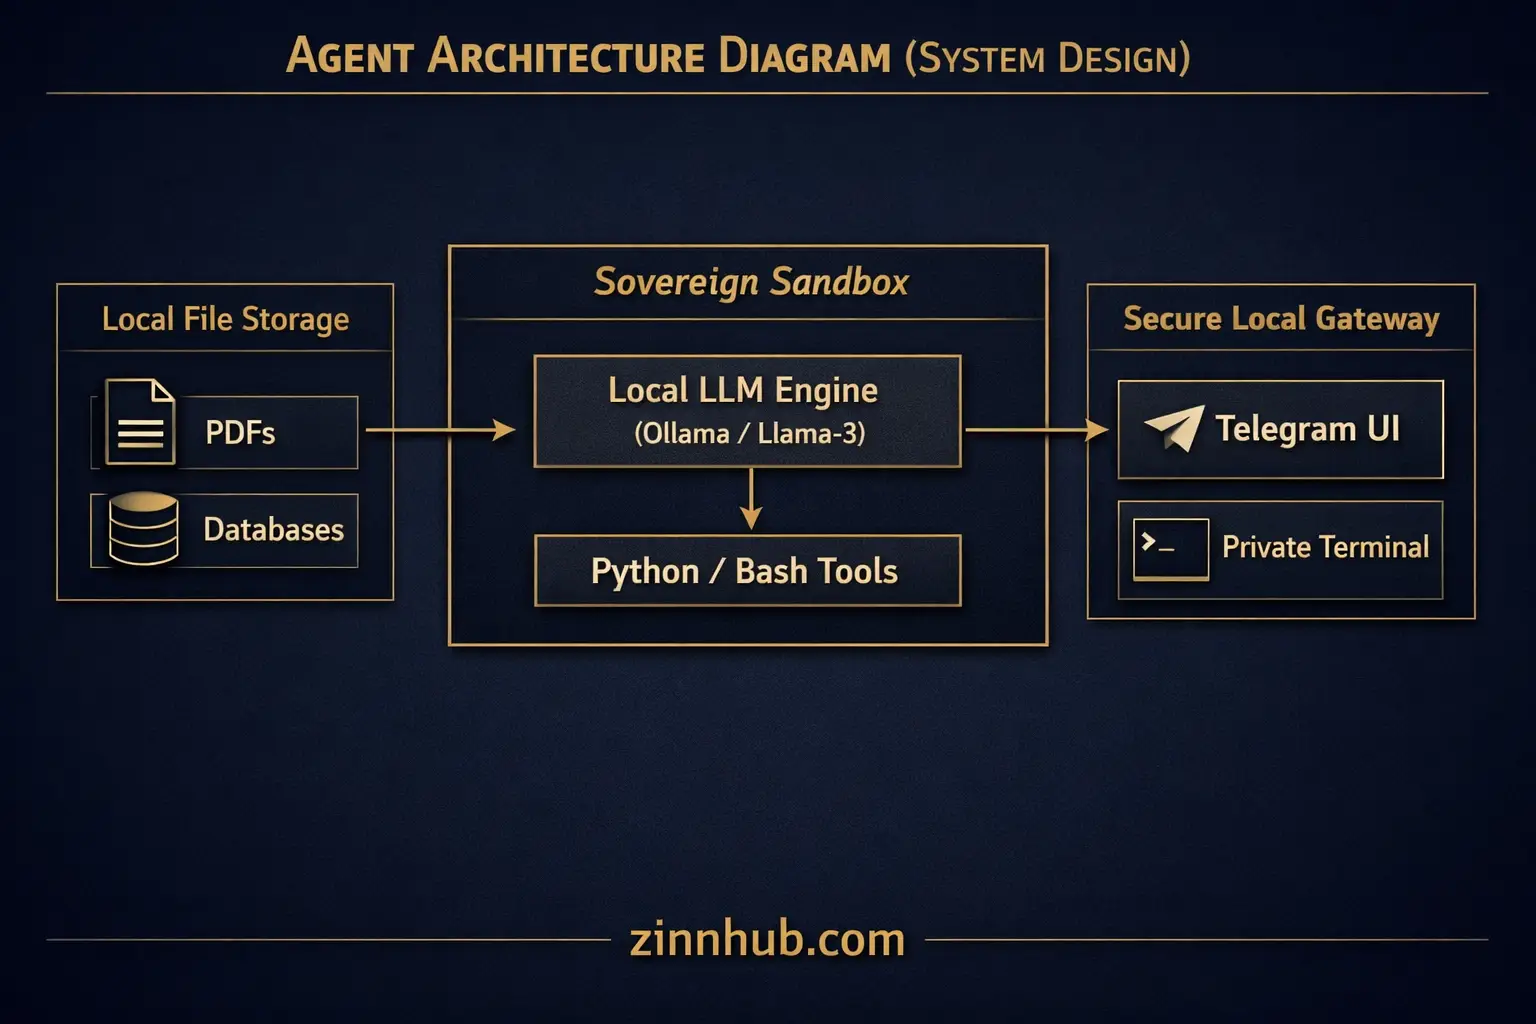
Der Betrieb lokaler LLMs und RAG-Pipelines erfordert ein präzises Gleichgewicht der Hardwareressourcen. Wenn Ihre Modellparameter Ihren verfügbaren GPU-VRAM oder System-RAM überschreiten, sinkt die Ausführungsgeschwindigkeit auf nahezu Null, da Ihr Betriebssystem gezwungen ist, Systemspeicher zu verwenden. Dies…
Ich werde ein Audit zur lokalen Hardware- und Modellkompatibilität durchführen
Fordern Sie ein individuelles Angebot an
Melden Sie sich an, um ein benutzerdefiniertes Angebot anzufordern
Erstellen Sie ein kostenloses Konto oder melden Sie sich an, um ein personalisiertes Angebot von diesem Zinner anzufordern.
Anmelden / RegistrierenStelle eine Frage vor dem Kauf
Bei Zinn anmelden, um eine Frage zu stellen
Um Spam auf der Plattform zu reduzieren, können Nachrichten vor dem Verkauf nur von angemeldeten Benutzern versendet werden.
Erstelle ein kostenloses Konto oder melde dich an, um diese Zinner direkt zu kontaktieren.
Anmelden / RegistrierenAnmeldung erforderlich
Erstelle ein kostenloses Konto oder melde dich an, um diese Zinner zu kontaktieren.
Anmelden / RegistrierenAnmeldung erforderlich
Erstellen Sie ein kostenloses Konto oder melden Sie sich an, um ein personalisiertes Angebot anzufordern.
Anmelden / RegistrierenAuf einen Blick
Wichtige Details zu diesem Service, um dir bei deiner Entscheidung zu helfen. Generiert von Zinn Hub, nicht vom Verkäufer.
Wertposition
Was Sie erhalten
Schnelle Bearbeitung
Was Sie bereitstellen müssen
Beste Wahl für
Vollständige Beschreibung
Das Ausführen lokaler LLMs und RAG-Pipelines erfordert ein präzises Gleichgewicht der Hardware-Ressourcen. Wenn Ihre Modellparameter Ihren verfügbaren GPU-VRAM oder Systemspeicher übersteigen, sinkt die Ausführungsgeschwindigkeit auf nahezu Null, da Ihr Betriebssystem gezwungen ist, den Systemspeicher zu nutzen.
Dieses Micro Zinn bietet ein vollständiges Kompatibilitäts-Audit Ihrer Hardware, bevor Sie Software kaufen oder installieren. Wir evaluieren Ihr physisches System – ob Apple Silicon Mac, NVIDIA CUDA-Workstation oder Standard-Windows-/Linux-Server – um Ihnen genau zu sagen, wie Sie optimale lokale Leistung erreichen.
Was wir analysieren:
1. GPU-VRAM-Beschränkungen: Wir ordnen Ihren dedizierten Grafikspeicher zu, um Ihre maximale Modellparameter-Obergrenze zu finden (z. B. 7B, 13B oder 34B Modelle).
2. System-RAM-Zuweisung: Wir bestimmen Ihre CPU-Inferenzschwellen und Offloading-Grenzen, wenn Sie keine dedizierte GPU haben oder auf gemeinsam genutztem Systemspeicher laufen.
3. Quantisierungszuordnung: Wir empfehlen das genaue Quantisierungsniveau (wie Q4_K_M, Q5_K_M oder Q8_0), um Verarbeitungsgeschwindigkeit und Modellintelligenz auszugleichen.
4. Kontextfenstergrenzen: Wir berechnen Ihre sicheren maximalen Token-Grenzen, um Systemabstürze aufgrund von Speichermangel bei intensiver Dokumentenabfrage zu verhindern.
Hören Sie auf zu raten, welche Open-Source-Gewichte Sie herunterladen sollen oder warum Ihr lokales Setup langsam ist. Erhalten Sie eine technisch optimierte, hardwarespezifische Karte für Ihre lokale KI-Umgebung von Betreibern, die diese Systeme täglich auf physischer Hardware aufbauen.
Abgeschlossenes Hardware-Kompatibilitäts-Audit mit Zuordnung von Ollama-Modellparametergrenzen, Kontextfenster-Skalierungen und optimalen Q4/Q5-Quantisierungen für 128 GB RAM.
Beispiel anzeigen ↗Ein Micro Zinn ist ein kleiner, zum Festpreis angebotener Schnupper- oder Micro-Service. CAVOK_Designs bietet diesen an für:
Fähigkeiten-ShowcasePortfolio-BuilderOffen für neue KundenZinner Qualitätsgarantie
Jeder Zinner wird überprüft und genehmigt, bevor er die Plattform beitritt.
Alle Dienstleistungen sind durch unser Qualitätssicherungsversprechen abgedeckt.
Ihre Zahlung ist geschützt, bis Sie die erbrachte Arbeit genehmigen.
Kundenbewertungen
Sehen Sie, was unsere Kunden über dieses Zinn sagen

