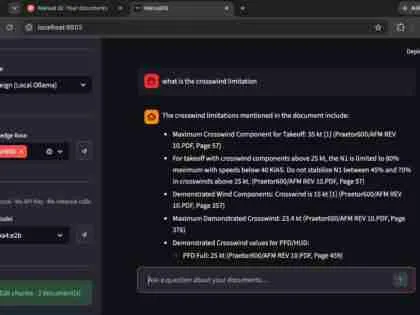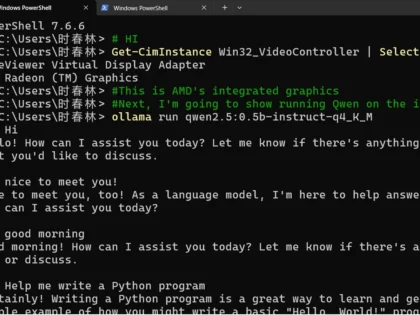
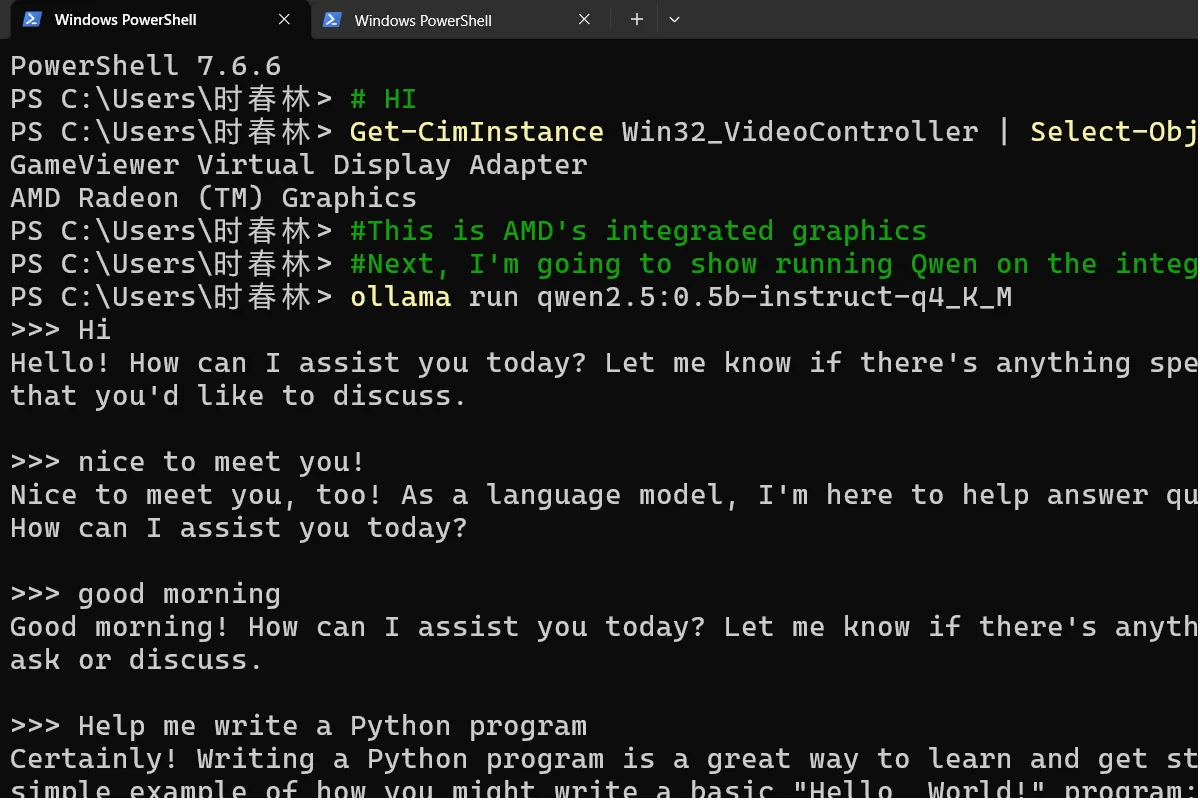
Haben Sie es satt, monatliche API-Gebühren zu zahlen? Ich werde ein 100% privates, offline lokales KI-Modell (Ollama, Qwen, Llama) auf Ihrer Hardware bereitstellen. Keine Datenlecks, unbegrenzte Nutzung. Schnelle Lieferung durch einen Full-Stack-Experten. Sehen Sie sich mein Portfolio an: www.dsecho.cn

Ich werde ein privates lokales KI-LLM bereitstellen und Python-Automatisierung auf Ihrer Hardware erstellen
Installieren Sie ein privates lokales LLM (Qwen/Llama) auf Ihrem PC mit Ollama. 100% offline und sicher.
- Lokales LLM-Setup
- Dokumentation enthalten
- 100% Offline & Privat
Alles in Basic, PLUS eine saubere Web-Benutzeroberfläche (Open WebUI) und benutzerdefinierte Python-Automatisierungsskripte.
- Alles in Basic
- Web-Benutzeroberfläche enthalten
- Benutzerdefinierte Python-Skripte
- Prioritäts-Support
Alles in Standard, PLUS erweiterte Hardware-Optimierung, komplexe Python-Automatisierung und 1-zu-1-technischer Support.
- Alles in Standard
- Hardware-Optimierung
- Erweiterte Automatisierung
- 1-zu-1-Support
Fordern Sie ein individuelles Angebot an
Melden Sie sich an, um ein benutzerdefiniertes Angebot anzufordern
Erstellen Sie ein kostenloses Konto oder melden Sie sich an, um ein personalisiertes Angebot von diesem Zinner anzufordern.
Anmelden / RegistrierenStelle eine Frage vor dem Kauf
Bei Zinn anmelden, um eine Frage zu stellen
Um Spam auf der Plattform zu reduzieren, können Nachrichten vor dem Verkauf nur von angemeldeten Benutzern versendet werden.
Erstelle ein kostenloses Konto oder melde dich an, um diese Zinner direkt zu kontaktieren.
Anmelden / RegistrierenAnmeldung erforderlich
Erstelle ein kostenloses Konto oder melde dich an, um diese Zinner zu kontaktieren.
Anmelden / RegistrierenAnmeldung erforderlich
Erstellen Sie ein kostenloses Konto oder melden Sie sich an, um ein personalisiertes Angebot anzufordern.
Anmelden / RegistrierenAuf einen Blick
Wichtige Details zu diesem Service, um dir bei deiner Entscheidung zu helfen. Generiert von Zinn Hub, nicht vom Verkäufer.
Wertposition
Bereitstellungsmethode
Unterstützte Modelle
Datenschutzstufe
Lieferung & Support
Was Sie erhalten
Vollständige Beschreibung
Sind Sie es leid, teure monatliche Abonnementgebühren an OpenAI oder Anthropic zu zahlen?
Machen Sie sich Sorgen, dass Ihre sensiblen Geschäftsdaten in die Cloud gesendet werden?
Hallo, ich bin Deep Stace Echo, der Gründer von DSEcho Studio (www.dsecho.cn). Ich bin ein Hardcore-Full-Stack-Entwickler, der sich auf den Aufbau von 100% privaten, offline und selbst gehosteten KI-Systemen spezialisiert hat.
Wenn Sie mit mir zusammenarbeiten, erhalten Sie ein System, das vollständig auf Ihrer eigenen Hardware läuft. Kein Internet erforderlich, keine Datenlecks und keine monatlichen API-Rechnungen.
Was Sie erhalten:
1. Lokale KI- & LLM-Bereitstellung
Ich werde modernste Open-Source-Modelle (wie Qwen oder Llama) direkt auf Ihrem PC, Mac oder Server mit Ollama bereitstellen und optimieren. Egal, ob Sie eine High-End-GPU oder nur eine CPU haben, ich werde das richtige Modell und das quantisierte Format konfigurieren, damit es reibungslos läuft.
2. Benutzerdefinierte KI-Agenten-Frameworks
Ich installiere nicht nur einfache Chatbots. Ich baue intelligente KI-Agenten mit erweiterten Funktionen:
-
Bionisches Gedächtnissystem: Ermöglicht der KI, lange Gespräche zu speichern und traditionelle Kontextfenstergrenzen zu umgehen.
-
Autonome Werkzeuggenerierung: Die KI kann ihre eigenen Python-Skripte schreiben und ausführen, um komplexe Aufgaben automatisch zu lösen.
3. Python-Automatisierung & Skripting
Müssen Sie Webdaten scrapen, Excel-Dateien verarbeiten oder einen sich wiederholenden Workflow automatisieren? Ich schreibe saubere, hocheffiziente Python-Skripte mit detaillierter Dokumentation, damit Sie sie leicht warten können.
Mein Prozess:
-
Diskussion: Sie senden mir Ihre Hardwarespezifikationen und Ziele.
-
Bereitstellung: Ich richte die Umgebung ein, lade die Modelle herunter und konfiguriere die Einstellungen remote oder stelle ein Ein-Klick-Skript bereit.
-
Testen & Lieferung: Wir testen das System gemeinsam. Ich stelle eine Schritt-für-Schritt-README (Dokumentation) zur Verfügung, damit Sie genau wissen, wie Sie Ihre KI verwenden und aktualisieren.
Warum mich wählen?
-
Direkte Kommunikation: Sie sprechen direkt mit dem Entwickler, der den Code schreibt. Keine Zwischenhändler, keine Agenturen.
-
Sauberer, dokumentierter Code: Ich liefere echten Wert, keine Blackbox.
-
Schnelle Lieferung: Die meisten Bereitstellungsaufgaben werden innerhalb von 24-48 Stunden abgeschlossen.
Hören Sie auf, sich auf die Cloud zu verlassen. Lassen Sie uns noch heute Ihre eigene private KI-Infrastruktur aufbauen!
Schreiben Sie mir vor der Bestellung, damit wir Ihre genauen Anforderungen besprechen und eine perfekte Passform gewährleisten können.
Zinner Qualitätsgarantie
Jeder Zinner wird überprüft und genehmigt, bevor er die Plattform beitritt.
Alle Dienstleistungen sind durch unser Qualitätssicherungsversprechen abgedeckt.
Ihre Zahlung ist geschützt, bis Sie die erbrachte Arbeit genehmigen.
Pakete vergleichen
| Merkmale | Basis | Standard-KI-Agent & Automatisierung | Premium Custom AI & Full Stack |
|---|---|---|---|
| Lieferzeit | 2 Tage | 3 Tage | 5 Tage |
| Überarbeitungen | 1 | 2 | 3 |
| Lokales LLM-Setup | ✓ | ✕ | ✕ |
| Dokumentation enthalten | ✓ | ✕ | ✕ |
| 100%Offline & Privat | ✓ | ✕ | ✕ |
| Alles in Basic | ✕ | ✓ | ✕ |
| Web-UI enthalten | ✕ | ✓ | ✕ |
| Benutzerdefinierte Python-Skripte | ✕ | ✓ | ✕ |
| Prioritäts-Support | ✕ | ✓ | ✕ |
| Alles in Standard | ✕ | ✕ | ✓ |
| Hardware-Optimierung | ✕ | ✕ | ✓ |
| Erweiterte Automatisierung | ✕ | ✕ | ✓ |
| 1-zu-1-Support | ✕ | ✕ | ✓ |
Portfolio
Beispiele für die Arbeit des Verkäufers im Zusammenhang mit diesem Zinn.
KI-Modelle auf AMD integrierter Grafik (iGPU) ausführen
Möchten Sie lokale LLMs ausführen, haben aber keine NVIDIA-GPU? Ich kann KI-Modelle (wie Qwen/Llama) direkt auf Ihrer integrierten AMD-Grafik mithilfe von Technologien wie Vulkan oder ROCm bereitstellen und optimieren. 100% offline und privat.
Servicedetails
Häufig gestellte Fragen
Bitte senden Sie mir vor der Bestellung eine Nachricht! Ich analysiere Ihre CPU/GPU und Ihren RAM, um festzustellen, welches quantisierte Modell (z. B. eine 4-Bit- oder 8-Bit-Version) reibungslos auf Ihrem Computer läuft. Wenn Ihre Hardware kein lokales LLM ausführen kann, erhalten Sie eine vollständige Rückerstattung.
Absolut. Sobald die Einrichtung abgeschlossen und das Modell heruntergeladen ist, können Sie Ihr Internetkabel abziehen und die KI funktioniert immer noch perfekt. Ihre Daten verlassen niemals Ihren Computer, was es perfekt für sensible Geschäftsunterlagen macht.
Kundenbewertungen
Sehen Sie, was unsere Kunden über dieses Zinn sagen
Kategorien
Zinner Richtlinien
Verwandte Zinns

Ich werde ein benutzerdefiniertes großes Sprachmodell für Ihr Unternehmen feinabstimmen
Ich extrahiere Text aus PDFs und Bildern mit fortschrittlicher OCR